
Hướng Dẫn Sử Dụng
Мониторинг HTTP-прокси с помощью Prometheus Blackbox Exporter и Alertmanager

Содержание
Почему прокси работает, а приложение всё равно теряет соединение?
Работающий процесс прокси не означает, что приложение может им пользоваться. Сервис может продолжать прослушивать сетевой порт, но при этом не иметь доступа в Интернет, выдавать ошибки аутентификации или не устанавливать туннель к целевому HTTPS-серверу.
Поэтому мониторинг HTTP-прокси должен проверять весь путь запроса: от узла мониторинга до прокси, от прокси до целевого сервера и получение корректного ответа. Простая проверка порта не отражает эту картину полностью.
Prometheus Blackbox Exporter выполняет внешнюю проверку, Prometheus собирает результаты, а Alertmanager направляет уведомления при выполнении условий оповещения. При правильной совместной настройке эти компоненты помогают выявлять недоступность и отслеживать тенденции изменения задержки.
Архитектура мониторинга и значение результатов
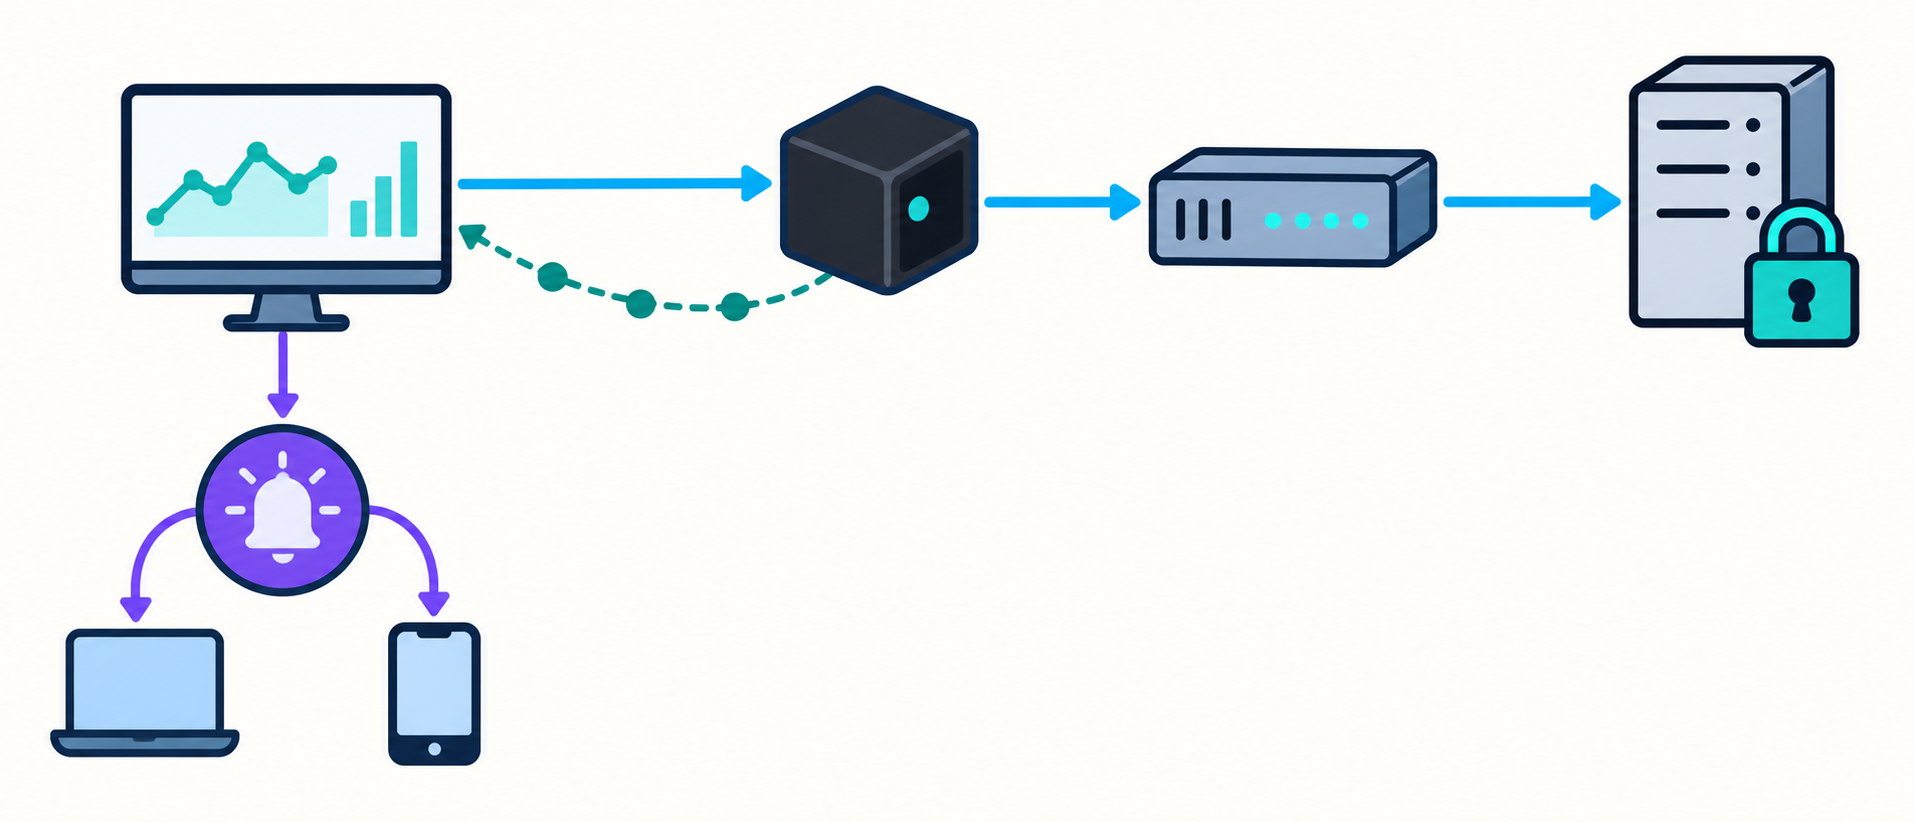
Проверка начинается, когда Prometheus обращается к эндпоинту /probe Blackbox Exporter. Экспортер использует настроенный HTTP-модуль, чтобы отправить запрос к проверочному URL через прокси, а затем возвращает метрики.
- Blackbox Exporter: выполняет HTTP-запрос и оценивает ответ.
- Prometheus: хранит временные ряды, выполняет выражения запросов и проверяет правила оповещения.
- Alertmanager: группирует оповещения, маршрутизирует уведомления и управляет периодами подавления уведомлений на время обслуживания.
- Проверочный эндпоинт: предоставляет стабильный ответ для подтверждения работоспособности пути через прокси.
Необходимо отличать проверку доступности прокси от проверки отдельного процесса. Такая проба отражает доступность всего выбранного пути. При неудаче причина может находиться в прокси, DNS, сети или целевом сервере.
Подготовка эндпоинта и выбор расположения экспортера
Выберите контролируемую цель проверки
Рекомендуется использовать эндпоинт, которым управляет ваша организация, с простым ответом и без необходимости интерактивного входа. Избегайте главных страниц с частыми перенаправлениями, меняющимся содержимым или зависимостью от множества внутренних сервисов.
Если приложение преимущественно обращается к HTTPS-ресурсам через HTTP-прокси, используйте HTTPS-цель. Тогда проверка будет включать установление туннеля CONNECT и TLS-соединения с целевым сервером, что точнее воспроизводит поведение приложения.
Можно добавить независимые цели проверки для сравнения. Если недоступна только одна цель, а остальные работают, следует сначала рассмотреть неисправность на стороне этой цели, прежде чем делать вывод о потере соединения через прокси.
Разместите экспортер в подходящем сетевом сегменте
Путь доступа экспортера к прокси должен быть аналогичен пути приложения, которое требуется контролировать. Успешная проверка из административной сети не гарантирует, что приложение в производственной сети тоже сможет подключиться.
Добавьте метки сетевого сегмента или места проверки, чтобы различать результаты. Также ограничьте доступ к экспортеру и контролируйте исходящий трафик, поскольку эндпоинт probe способен отправлять запросы по указанным адресам.
Настройка Prometheus Blackbox Exporter для HTTP-прокси
Создайте HTTP-модуль с использованием прокси
В конфигурации Blackbox Exporter объявите модуль с prober: http. В разделе http задайте в proxy_url адрес прокси, например http://proxy.internal:3128. Это пример адреса, который необходимо заменить реальными данными.
Prometheus выбирает модуль через параметр module. В свою очередь, параметр target должен содержать URL цели, к которой требуется обратиться через прокси, а не адрес самого прокси. Если перепутать эти адреса, проверка может не соответствовать поставленной задаче.
- method: выберите метод, подходящий для проверочного эндпоинта.
- valid_status_codes: укажите допустимые коды ответа, если они должны отличаться от значений по умолчанию.
- follow_redirects: определите, нужно ли следовать перенаправлениям.
- timeout: ограничьте время выполнения проверки.
- fail_if_body_not_matches_regexp: можно использовать для проверки ожидаемого содержимого.
Если эндпоинт возвращает специальную строку подтверждения, проверка содержимого помогает не принять промежуточную страницу ошибки за успешный ответ. Однако не следует привязываться к содержимому, которое часто меняется.
Настройте учетные данные и TLS
Различайте аутентификацию на прокси и аутентификацию на целевом сервере. Поля HTTP-аутентификации, предназначенные для цели, не заменяют автоматически учетные данные прокси. Проверьте, какой механизм поддерживается используемой версией экспортера.
Не размещайте пароли в метках Prometheus, URL цели или тексте уведомлений. Если учетные данные присутствуют в конфигурации, необходимо ограничить права чтения, организовать управление секретами и не сохранять их в репозитории исходного кода.
Для HTTPS-целей оставляйте проверку сертификатов включенной и настройте подходящий CA при использовании внутренних сертификатов. Отключение проверки TLS снижает ценность пробы и может скрыть ошибки, с которыми действительно сталкивается приложение.
Настройка сбора результатов проб в Prometheus
Создайте отдельное задание сбора метрик, задайте metrics_path равным /probe и передайте имя модуля в params. Целями задания служат проверочные URL, а адрес экспортера подставляется с помощью relabeling.
Типичная последовательность relabeling выглядит следующим образом:
- Перенесите исходное значение __address__ в __param_target, чтобы экспортер получил URL цели.
- Скопируйте __param_target в instance для идентификации цели в результатах.
- Замените __address__ адресом Blackbox Exporter, чтобы Prometheus обращался к нужному сервису.
Добавьте стабильные метки, такие как proxy_id, environment и region. Если прокси несколько, можно создать соответствующие модули и выбирать нужный через конфигурацию задания или relabeling. Метка, описывающая прокси, сама по себе не меняет proxy_url модуля.
Тайм-аут модуля должен быть согласован с scrape_timeout, при этом необходимо оставить время для возврата результатов экспортером. Интервал сбора метрик и длительность сохранения условия оповещения следует выбирать исходя из эксплуатационных требований, а не копировать универсальное пороговое значение.
Правильная интерпретация метрик доступности и задержки
Различайте probe_success и up
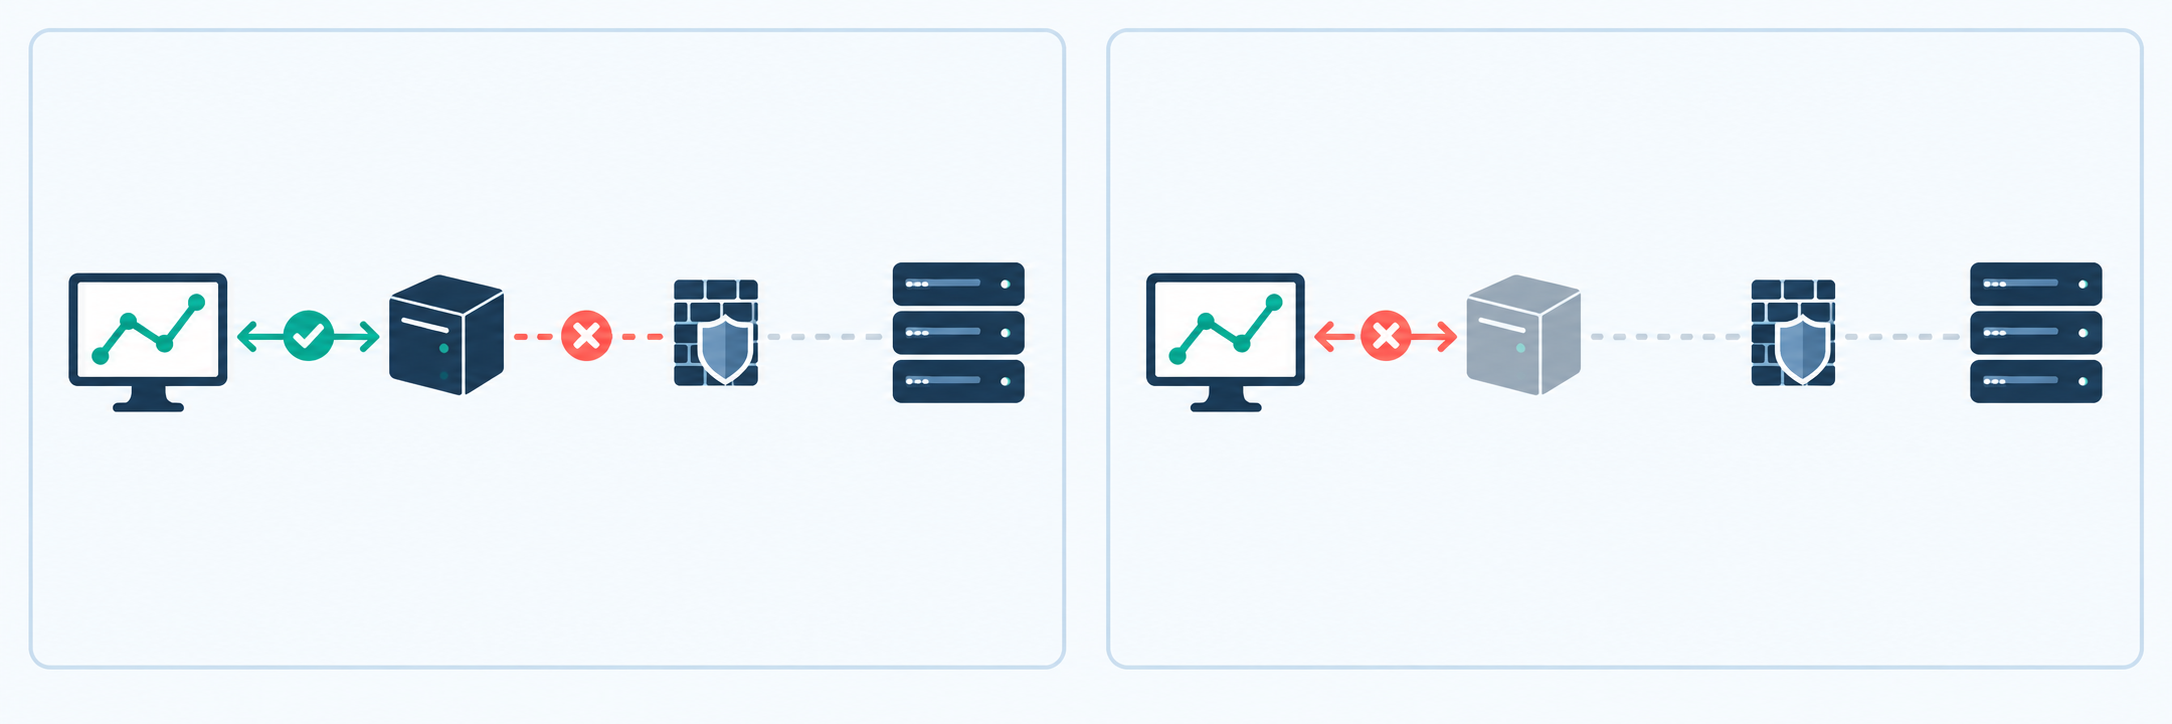
probe_success показывает, соответствует ли проверка условиям успеха. Выражение probe_success{job="blackbox-http-proxy"} == 0 выбирает неудачные проверки.
В то же время up отражает, удалось ли Prometheus успешно собрать метрики с эндпоинта экспортера. Экспортер может штатно возвращать метрики, даже если запрос через прокси завершился неудачей. Поэтому наблюдение только за up приведет к пропуску сбоев на пути через прокси.
Учитывайте ограничения измерения задержки
probe_duration_seconds отражает общее время выполнения пробы. Это полезный показатель времени выполнения запроса через прокси, но не задержка самого прокси.
probe_http_duration_seconds предоставляет длительность отдельных HTTP-фаз, зарегистрированных экспортером. При использовании прокси, особенно с CONNECT, нельзя по умолчанию считать, что каждая фаза полностью соответствует отдельному сетевому компоненту. Необходимо сверяться с реализацией и диагностическими журналами используемой версии.
Задержку успешных проб следует рассматривать отдельно от задержки неудачных. Быстро отклоненный запрос имеет малую длительность, но это не признак хорошего качества работы. При анализе тенденций всегда размещайте график задержки рядом со статусом успешности.
Настройка оповещений о потере соединения через прокси
Создайте условие оповещения с периодом подтверждения
Создайте правило оповещения на основе выражения probe_success{job="blackbox-http-proxy"} == 0. Добавьте поле for, чтобы состояние ошибки должно было сохраняться непрерывно до перехода оповещения в состояние firing.
Период подтверждения должен обеспечивать баланс между скоростью обнаружения и устойчивостью к кратковременным сбоям. Выбирайте его с учетом интервала сбора метрик, критичности прокси и реальных эксплуатационных данных.
В annotations точно укажите, что проверка через прокси завершилась неудачей, вместо утверждения, что процесс прокси остановлен. Уведомление должно содержать сведения о прокси, окружении, цели проверки и рекомендации по первоначальным действиям.
Оповещайте о потере наблюдаемости
Создайте отдельное оповещение для up{job="blackbox-http-proxy"} == 0. Такой случай означает, что Prometheus не может получить результаты пробы, но сам по себе не доказывает неисправность прокси.
Если цель удалена из конфигурации или системы обнаружения сервисов, временной ряд может исчезнуть, а не перейти в значение ошибки. Для известного набора меток можно использовать absent или absent_over_time; при наличии множества прокси необходимо сверяться со списком ожидаемых прокси, чтобы выявлять отсутствие каждого из них.
Маршрутизация уведомлений через Alertmanager
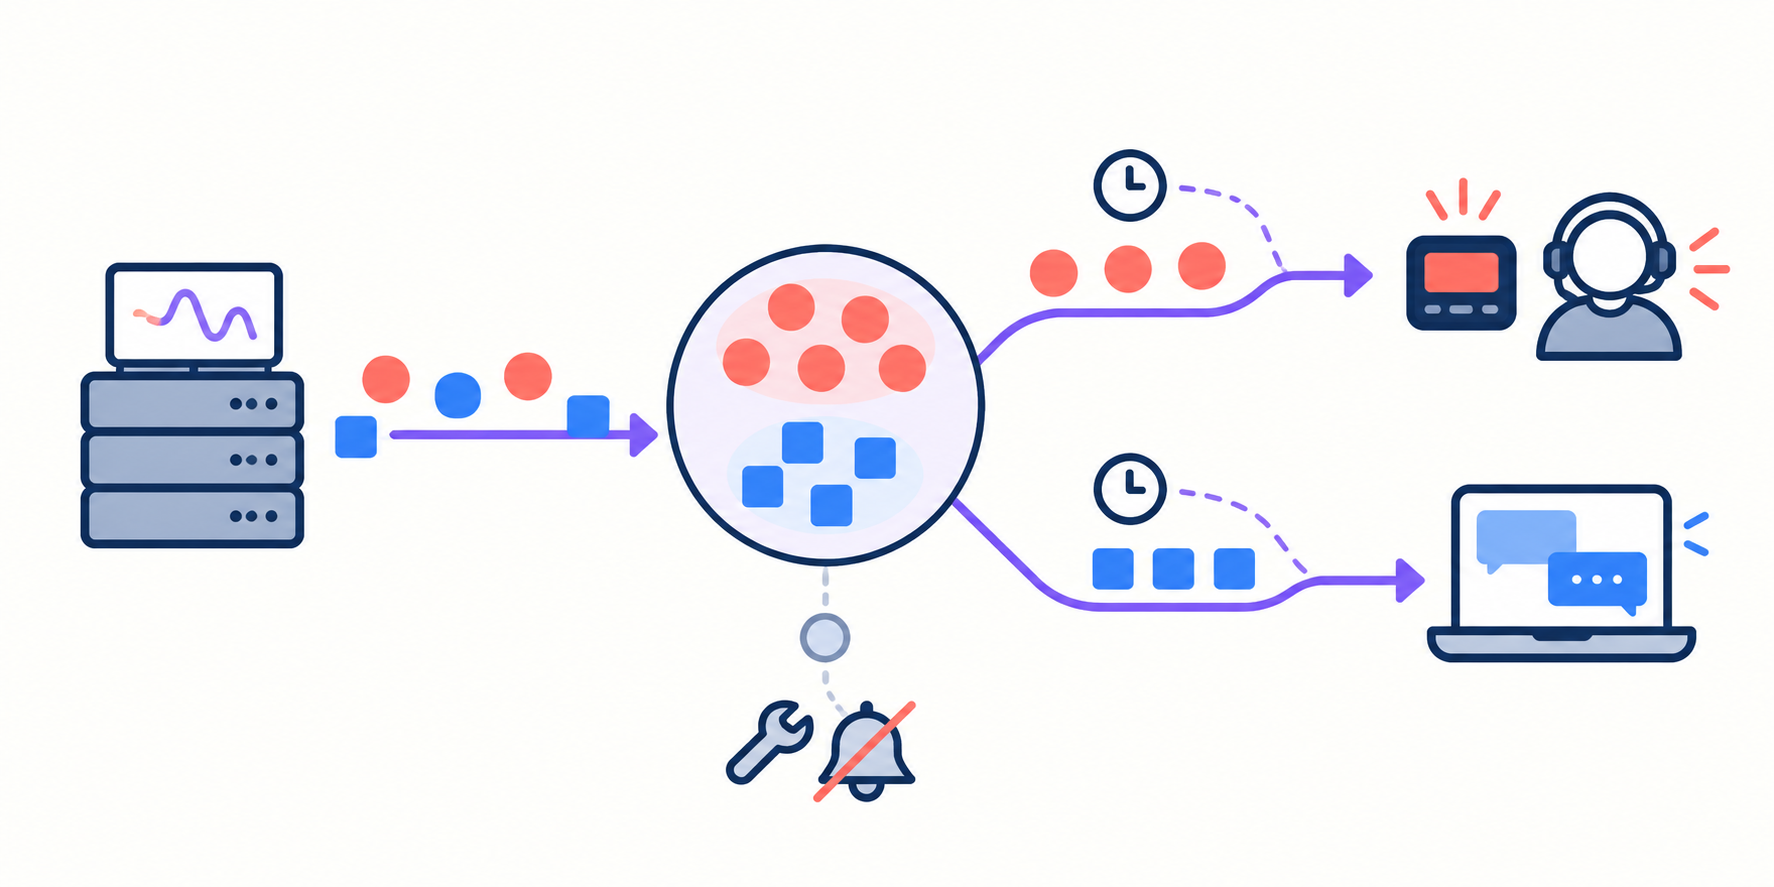
Prometheus проверяет правила и отправляет оповещения в Alertmanager. Alertmanager не выполняет пробы самостоятельно: его задача — группировать, маршрутизировать и отправлять уведомления настроенному получателю.
Можно группировать оповещения по имени, прокси и окружению, чтобы сохранить необходимый контекст. Направляйте уведомления из производственной среды дежурной команде эксплуатации, а из тестовой — в канал с более низким уровнем срочности.
- group_wait: задает время ожидания перед отправкой первого уведомления группы.
- group_interval: регулирует отправку уведомлений об обновлениях в группе.
- repeat_interval: определяет время повторного уведомления об оповещениях, которые остаются активными.
Используйте silence для планового обслуживания и включите уведомления о восстановлении, если получатель их поддерживает. Применяйте inhibition только при четко установленных зависимостях; не следует автоматически считать любой сбой пробы следствием неисправности экспортера.
Проверка перед вводом в эксплуатацию
Перед перезагрузкой проверьте синтаксис конфигурации и правил подходящими инструментами. Затем воспроизведите каждый сценарий в среде, где такие действия разрешены, чтобы проверить всю цепочку обнаружения и уведомления.
- Заблокируйте соединение от экспортера к прокси, чтобы подтвердить неудачное завершение пробы.
- Используйте неверные учетные данные и убедитесь, что уведомления не раскрывают секреты.
- Сделайте проверочный эндпоинт недоступным, чтобы отличить сбой цели от сбоя прокси.
- Остановите экспортер, чтобы проверить оповещение о потере данных мониторинга.
- Восстановите работу сервиса и убедитесь, что уведомление со статусом resolved отправлено нужному получателю.
Во время диагностики можно вызвать пробу с параметром debug=true, чтобы увидеть подробности обработки. Используйте его только в контролируемой среде и проверяйте журналы на наличие конфиденциальных данных перед передачей другим лицам.
Заключение
Эффективный мониторинг HTTP-прокси требует сочетания сквозных проверок, правильной интерпретации метрик и проверенного процесса оповещения. Prometheus Blackbox Exporter предоставляет данные о доступности и времени выполнения запросов, а Prometheus вместе с Alertmanager превращают эти данные в сигналы для эксплуатации.
Самое важное — различать сбои пути через прокси, ошибки эндпоинта и неисправности системы мониторинга. Когда конфигурация точно отражает путь запросов приложения, оповещения о потере соединения через прокси получают ясный контекст и помогают эффективнее устранять неполадки.
Похожие статьи
Хватит читать — пора подключить настоящий прокси?
Residential, ISP, Datacenter или Mobile прокси — готовы за пару минут.
Смотреть продукты