
代理知识
大规模网页数据采集的 IPv6 Residential Proxy 使用指南

目录
IPv6 Residential Proxy 在网页数据采集中的简介
在数字化时代,数据被视为每个企业无价的资产。然而,从大规模电子商务平台、社交网络或新闻网站提取和采集信息变得越来越复杂。现代防火墙系统和反爬虫(anti-bot)机制不断升级,以检测和阻止异常访问。
为了解决这一问题,选择代理基础设施起着决定性作用。在现有的解决方案中,proxy ipv6 residential(IPv6 住宅代理)脱颖而出,成为首选工具,为数据工程师提供无限的扩展能力和最佳的成本效益。
为什么大规模 Crawl Data 项目应选择 IPv6 Residential Proxy?
与传统的 IPv4 或数据中心代理(Datacenter Proxy)相比,proxy dân cư ipv6拥有显著优势,有助于优化数据采集性能。
1. 几乎无限的 IP 地址空间
 IPv6 协议提供的海量 IP 地址资源,为大规模数据采集系统奠定了坚实的扩展基础。
IPv6 协议提供了约 3,400 亿亿亿个 IP 地址。这种丰富性彻底解决了 IPv4 IP 地址短缺的问题。因此,服务提供商可以创建极其多样化的 crawl data proxy 网络,允许您的系统同时发起数百万个查询,而无需担心 IP 资源耗尽。
2. 高可靠性与绝对匿名率
住宅 IP 是电信运营商(ISP)分配给真实家庭设备的网络地址。当通过 proxy ipv6 residential 发送请求时,采集爬虫的流量看起来与普通用户完全一样。这有助于系统绕过大多数自动检测机制,最大程度地减少 CAPTCHA 验证码障碍和 IP 地址被封禁的风险。
3. 优化大型项目的运营成本
由于 IPv6 地址供应量巨大,每 GB 数据或 IPv6 IP 数量的成本明显低于 IPv4。对于每天部署数百万个页面的proxy thu thập dữ liệu系统的企业来说,切换到 IPv6 可以节省高达 50-70% 的基础设施预算。
将 IPv6 住宅代理配置并集成到 Web Scraping 系统的指南
为了在实际项目中有效部署 proxy dân cư ipv6,您需要遵循以下标准化步骤:
步骤 1:确认目标网站对 IPv6 的支持情况
在投资代理系统之前,请确保要爬取的网站服务器支持 IPv6 协议。您可以使用简单的命令行工具进行检查:
ping -6 target-website.com 或 nslookup -type=AAAA target-website.com
如果命令返回了 IPv6 地址(格式为 8 组十六进制字符),您完全可以使用 proxy ipv6 residential 来采集数据。
步骤 2:设置 IP 轮换机制(IP Rotation)
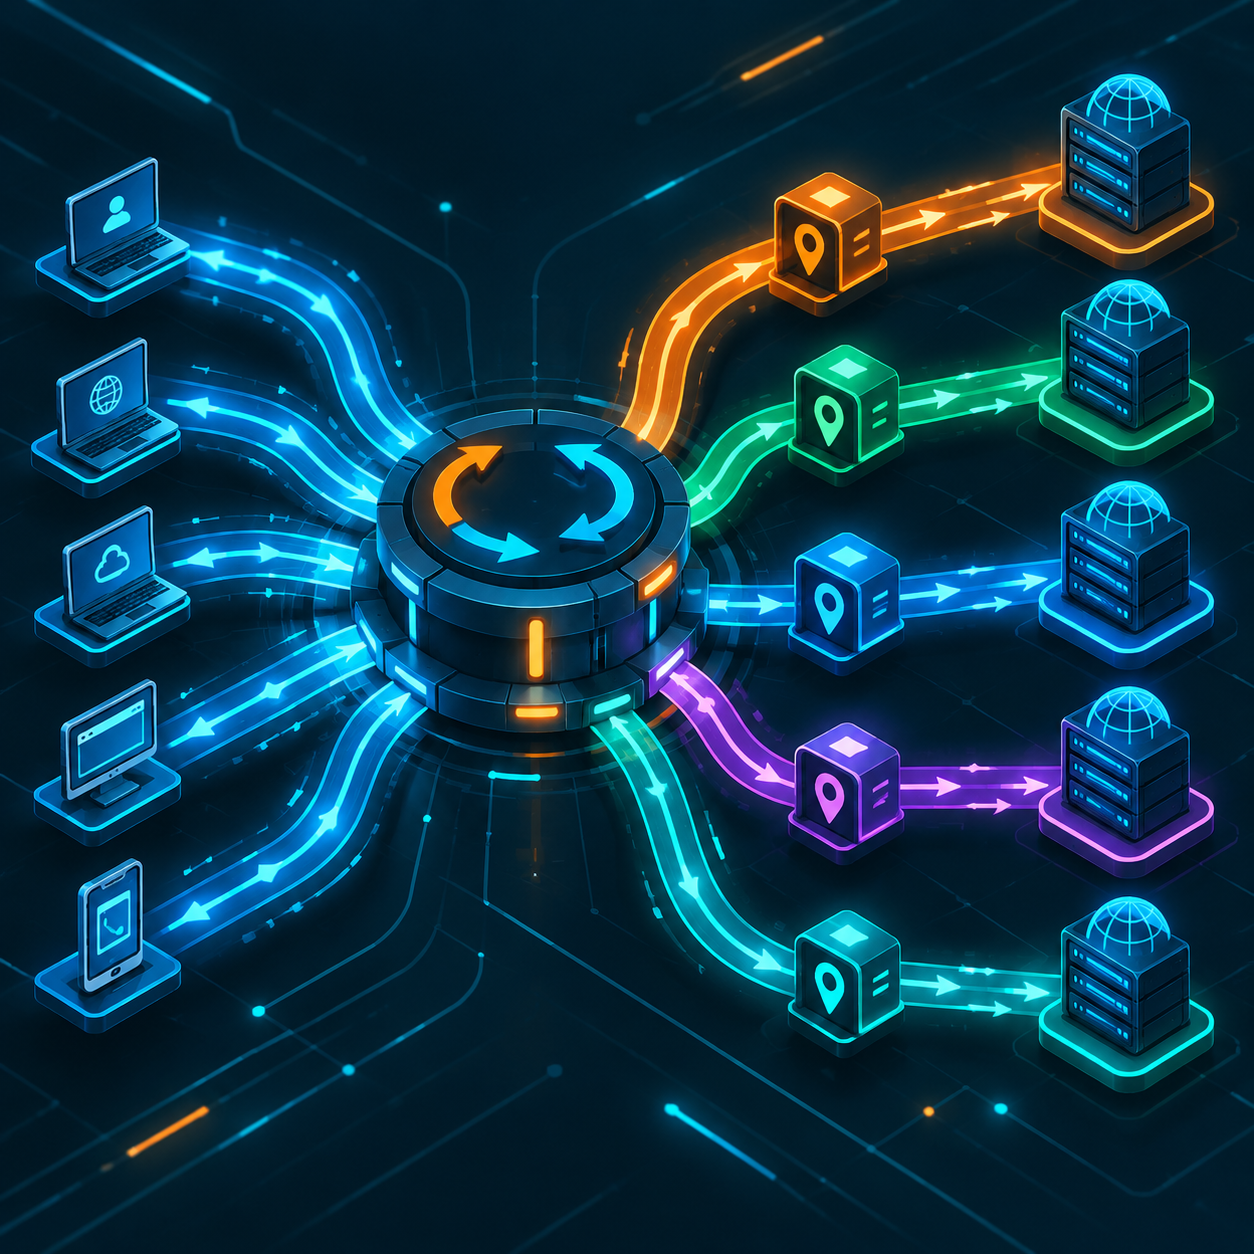 通过 IP 轮换机制,数据采集系统能够灵活切换身份,有效绕过各种反爬虫防护。
大规模数据采集需要持续轮换 IP。有两种常见的 IP 轮换方法:
- 按请求轮换 IP (Sticky/Random Rotation):发送的每个 HTTP 请求都将使用一个全新的 IP。这是提取单页数据、产品详情或文章任务的理想选择。
- 按会话轮换 IP (Session-based Rotation):在一定时间内(例如 5-10 分钟)保持同一个 IP,以执行需要登录或维持购物车状态的工作流程。
步骤 3:将代理集成到数据采集脚本中(以 Python 为例)
以下是将 IPv6 类型的 crawl data proxy 集成到 Python 常用 requests 库中的方法:
简单配置示例代码:
- 声明代理身份验证信息(Host、Port、Username、Password)。
- 通过自动轮换代理网关发送 HTTP 请求。
- 处理异常并记录响应状态日志。
获得最佳效果的重要技术注意事项
 合理配置请求头、控制访问频率并建立重试机制,是保障爬虫系统稳定高效运行的关键。
尽管 IPv6 proxy thu thập dữ liệu带来许多好处,但您仍需遵循以下技术原则,以确保系统稳定运行:
- 优化 HTTP 请求头(HTTP Headers):将代理与灵活更改 User-Agent、Accept-Language 和 Sec-Ch-Ua 结合起来,以精准模拟真实浏览器的行为。
- 控制访问频率(Rate Limiting):即使拥有庞大的 IP 池,也不应在过短的时间内向同一服务器发送过多并发请求,以避免给目标系统带来过大负荷。
- 智能错误处理:建立遇到 403、429 或 503 错误时的自动重试机制(Retry mechanism),以确保所采集数据的完整性。
结论
使用 proxy ipv6 residential 是帮助企业在大规模数据采集方面取得突破的战略解决方案。凭借在成本、IP 地址数量和可靠性方面的显著优势,该代理系列使 crawl data proxy 流程比以往任何时候都更加顺畅、稳定和高效。立即开始升级您的数据采集基础设施,以优化性能并提升市场竞争优势。