
代理知识
使用 Scrapy 框架配置轮换代理(Rotating Proxy)监控电商竞品价格指南

目录
提出问题:为什么监控竞品价格决定了电商平台的生死存亡?
在电子商务市场爆发式增长的背景下,价格已成为关乎生存的关键竞争因素之一。Shopee、Lazada、Tiki 或 Amazon 等大型电商平台上的价格战每时每刻都在上演。能最快掌握竞争对手价格变动的企业,将在自动动态定价(dynamic pricing)、优化广告活动和保护利润率方面占据最大优势。
然而,大规模收集价格数据面临着来自反爬虫(anti-bot)防御系统的巨大技术壁垒。电商平台采用了许多复杂机制,例如访问频率限制(rate limiting)、IP 封禁、CAPTCHA 验证码要求或浏览器指纹检查。如果您仅使用单个 IP 地址在短时间内访问数千个产品页面,您的 IP 将立即被封禁(block)。这就是为什么结合 proxy scrapy python 和 rotating proxy scrapy 技术成为解决抓取电商价格问题的专业标准方案。
轮换代理在抓取电商数据中的作用
代理(Proxy)充当数据收集应用程序(Scrapy Spider)与目标网站之间的中间服务器。使用代理时,抓取服务器的真实 IP 地址将被隐藏,目标网站仅记录代理服务器的 IP。
但是,如果仅使用静态代理(Static Proxy),在发送大量请求时被发现和封禁的风险仍然很高。rotating proxy scrapy(IP 轮换)技术会自动为每个 HTTP 请求或在特定时间间隔后更改出口 IP 地址。这带来了诸多显著优势:
- 突破频率限制(Rate Limit): 将数千个请求分散到数百个不同的 IP 地址,使网站的监控系统将其视为来自多个独立用户的自然访问。
- 避免大规模 IP 封禁: 如果某个 IP 被发现并被临时封禁(返回 HTTP 错误 403 Forbidden 或 429 Too Many Requests),系统将立即剔除该 IP 并切换到另一个干净的 IP 继续工作,不会中断整个进程。
- 按地理位置收集数据(Geo-targeting): 许多电商平台会根据买家的地理区域显示不同的价格和运费。轮换代理允许您选择特定省市或国家的 IP,以收集最准确的价格信息。
Scrapy Proxy Middleware 架构概述
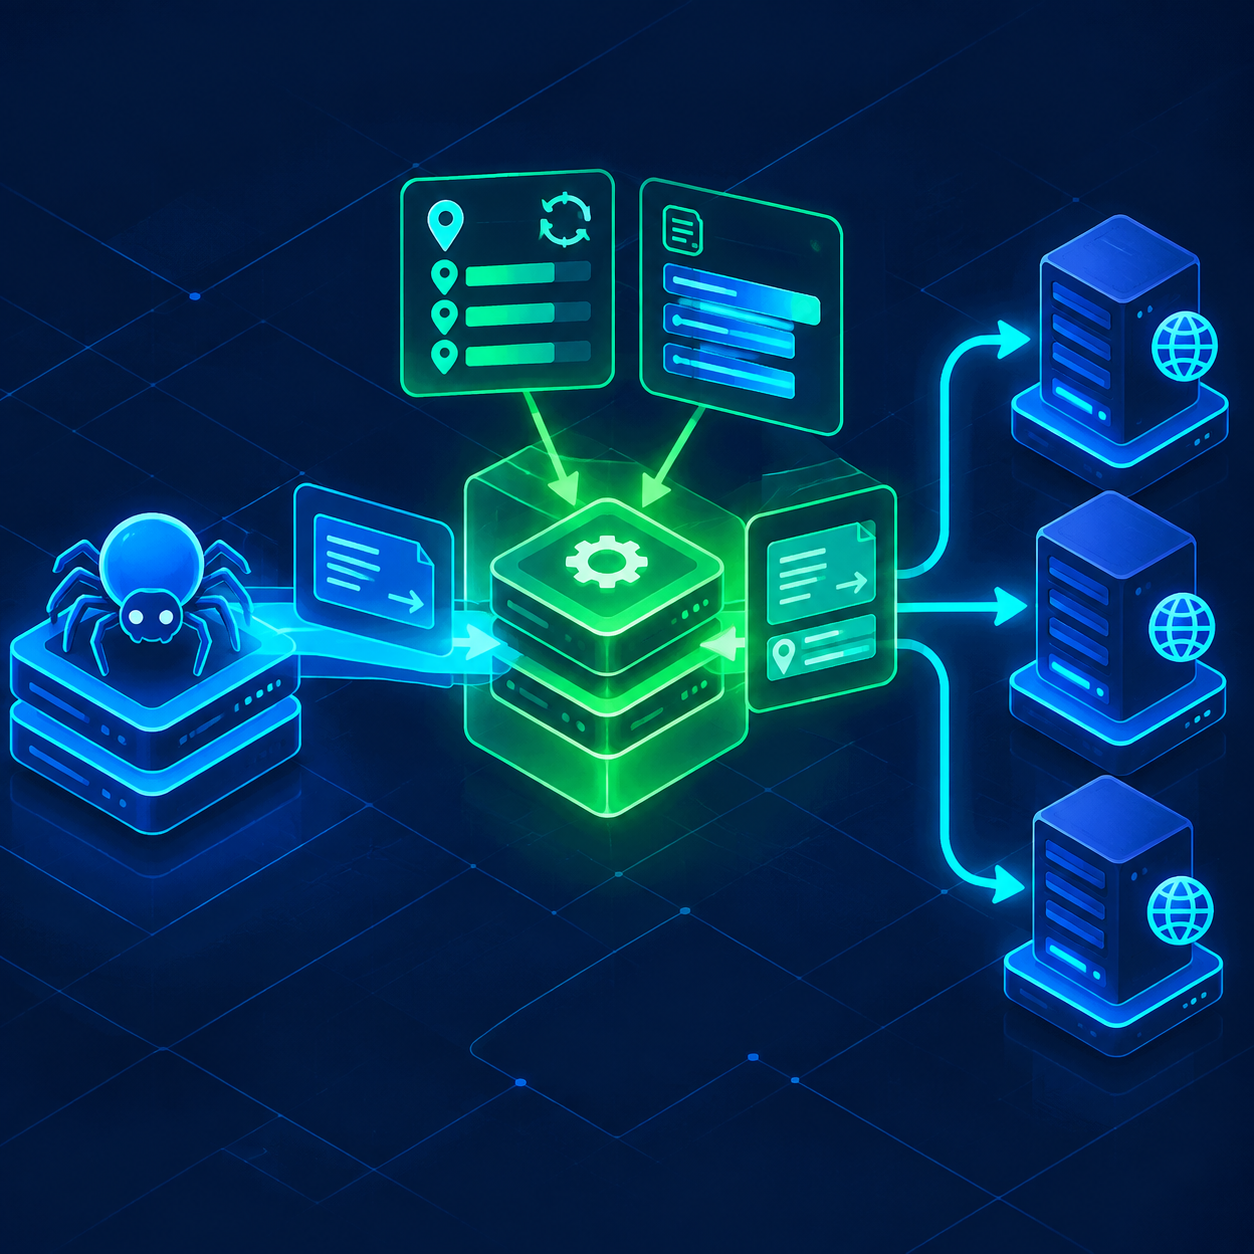 Scrapy Downloader Middleware 位于请求链的核心位置,负责拦截并动态注入代理 IP。
Scrapy 是一个用 Python 编写的强大框架,专门用于网页抓取任务。Scrapy 中 IP 管理和轮换的核心在于 scrapy proxy middleware(下载器中间件 / Downloader Middleware)组件。
Downloader Middleware 位于 Downloader Engine 和 Request/Response 管道之间。每当 Spider 发起一个 Request 时,它都会在发送到互联网之前穿过 Downloader Middleware。在这里,我们可以干预 Request header、分配代理地址、更改 User-Agent 或处理从目标服务器返回的异常。
使用 Scrapy 配置轮换代理的详细指南
步骤 1:准备环境和 Scrapy 项目
首先,您需要确保已安装 Python(3.8 或更高版本)和虚拟环境(virtualenv)。使用标准的终端命令安装 Scrapy 框架及依赖库。
创建新的 Scrapy 项目后,您将获得一个标准的目录结构,其中包括重要文件如 settings.py、middlewares.py 以及 spiders/ 目录。
步骤 2:选择轮换代理实施方案
目前有两种主要方法可以将 rotating proxy scrapy 集成到您的 Python 项目中:
- 使用现有的开源扩展包(scrapy-rotating-proxies): 适用于自定义管理的代理列表(IP:Port 列表)。该库会自动跟踪每个 IP 的性能,暂停出现错误或被封禁的 IP,并优先使用正常工作的 IP。
- 使用轮换代理服务后端(Proxy Provider Endpoint): 专业代理提供商(如 Bright Data、Oxylabs、Smartproxy)提供单一端点(例如:proxy.example.com:8080)。通过该端点发送的每个请求都会在提供商服务器端自动轮换到新的 IP。对于超大规模项目,这种方法最简单且最有效。
步骤 3:构建自定义 Scrapy Proxy Middleware
为了最大化控制请求处理流程,编写自定义 scrapy proxy middleware 是数据工程师的首选解决方案。以下是在 middlewares.py 文件中需要构建的核心逻辑流程:
在 process_request 方法中,我们从可用列表或 IP 轮换服务中提取一个代理地址,然后直接赋值给 request.meta['proxy'] 属性。如果代理需要用户名和密码验证,登录信息需进行标准 Base64 编码并赋给 Proxy-Authorization 请求头。
在 process_response 方法中,中间件将检查电商平台返回的 HTTP 状态码。如果遇到怀疑被封禁的错误代码(如 403、429、503)或出现验证码页面,中间件将禁用当前 IP,切换到新 IP,并将该 Request 重新放回调度器(scheduler)进行重试(retry)。
步骤 4:在 settings.py 中进行配置
settings.py 文件充当整个爬虫的控制中心。为了优化抓取电商价格并顺畅集成代理,您需要更新以下参数:
通过在 DOWNLOADER_MIDDLEWARES 属性中声明自定义中间件并指定合适的优先级(priority)来激活它,通常设置在 300 到 750 之间,以确保它在处理数据压缩或 Cookie 的中间件之前运行。
除非必须登录,否则请关闭 Cookie 管理机制(COOKIES_ENABLED = False)。发送带有不同 IP 的固定 Cookie 是反爬虫系统识别异常行为的主要标志之一。
调整并发性和延迟参数。拥有高质量的 rotating proxy scrapy 系统后,您可以增加 CONCURRENT_REQUESTS 以提高采集速度。但是,仍建议设置较小的随机 DOWNLOAD_DELAY(AutoThrottle 扩展),以减轻目标服务器的压力,并避免触发基于请求密度的异常检测算法。
实战中优化电商价格抓取方案
抓取电商平台的价格数据比仅仅从新闻页面提取文本要复杂得多。以下是一些高级技巧,可帮助您的系统 24/7 全天候稳定运行。
1. 结合轮换代理与轮换 User-Agent
实施 proxy scrapy python 时的常见错误是仅轮换 IP 而保持 User-Agent 字符串不变。当来自全球 IP 的数千个请求具有完全相同的浏览器详细参数时,电商平台的安全系统很容易将其识别并打上标记。
因此,您应该集成自动 User-Agent 轮换库(如 scrapy-user-agents),以确保每个 IP 都伴随着来自 Chrome、Firefox、Safari 到移动设备的多样化且合法的浏览器指纹(Browser Fingerprint)。
2. 选择合适的代理类型
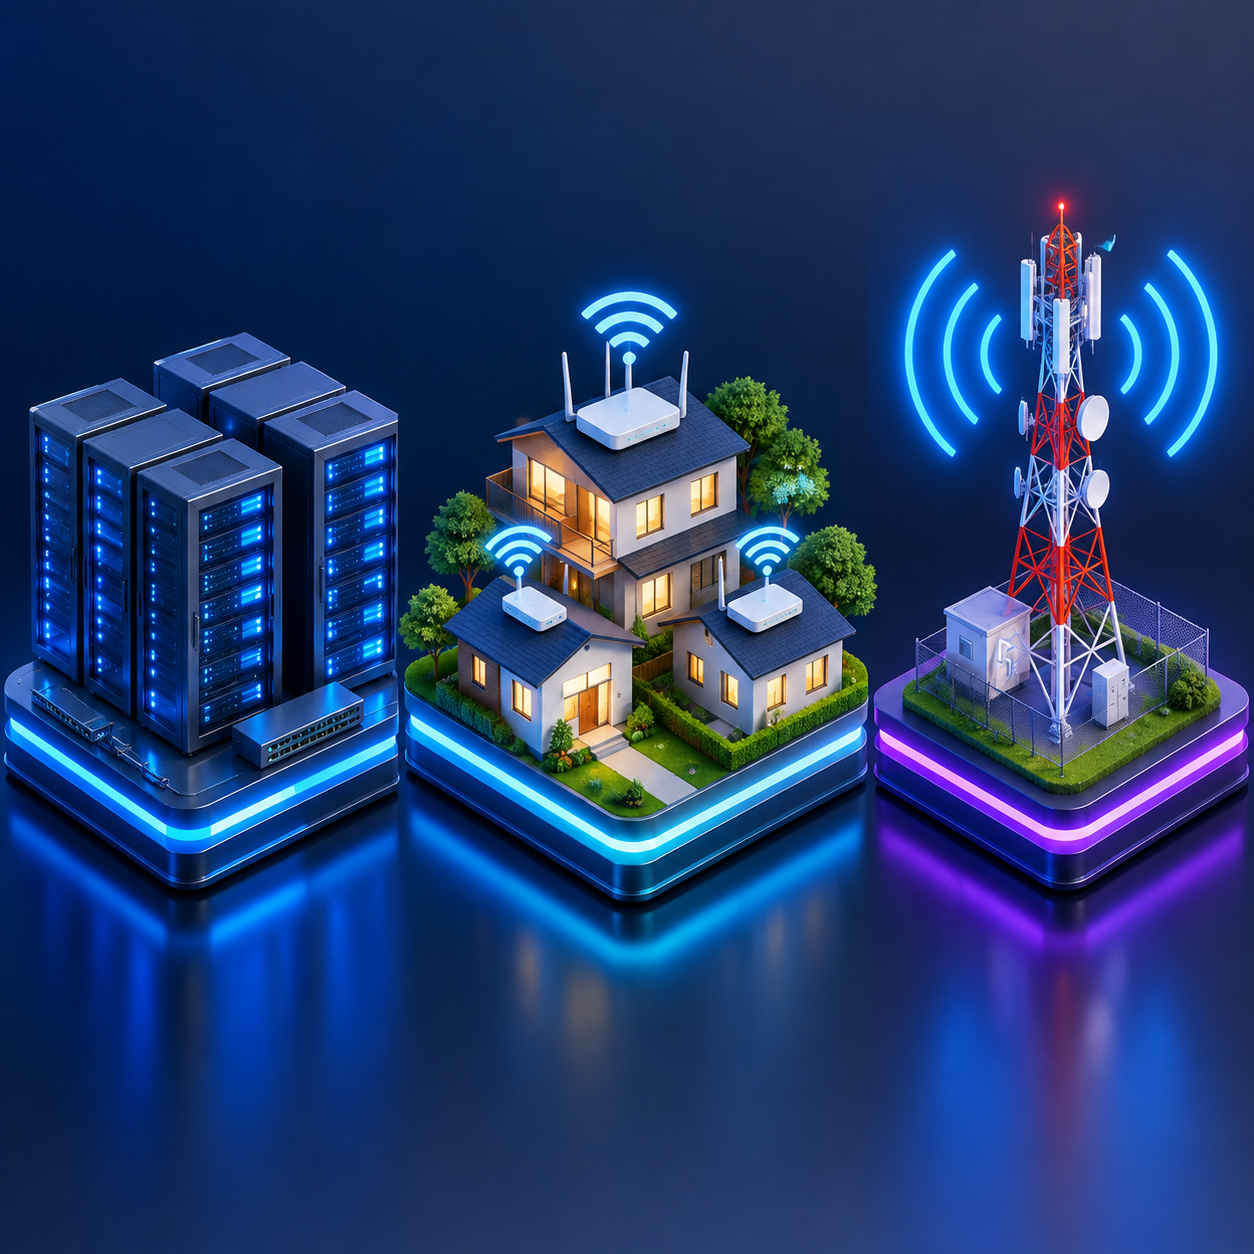 数据中心代理、住宅代理与移动代理在隐蔽度与成本上的直观对比。
在抓取电商价格问题中,并非所有代理价值都相同:
- Datacenter Proxies(数据中心代理): 速度极快且成本低廉,但 IP 段属于云服务提供商(AWS、DigitalOcean 等)。大型电商平台很容易识别并批量封禁这些 IP 段。
- Residential Proxies(住宅代理): 由网络运营商(ISP)分配给家庭用户的真实 IP 地址。这是抓取价格最有效的代理类型,因为访问流量与真实用户完全一致,被封禁的概率极低。
- Mobile Proxies(移动代理 3G/4G/5G): 使用移动网络连接,具有最高的可靠性,但成本也最昂贵。通常仅在面对具有最严格反爬虫系统的页面时用作备用方案。
3. 处理动态数据(JavaScript 渲染)与 AJAX 请求
许多现代电商网站将价格信息隐藏在 AJAX API 查询后面,或使用 React/Vue/Angular 构建前端界面。仅发送普通 HTML 请求将无法获取产品价格。
最佳方法是使用浏览器的开发者工具(F12 Network Tab)来寻找直接返回 JSON 价格数据的 API 端点。找到该端点后,您只需使用 Scrapy 搭配 scrapy proxy middleware 直接向该 API 发送请求。与使用 Selenium 或 Playwright 等无头浏览器相比,这种方法可以将抓取速度提高数十倍。
错误控制与自动抓取系统监控
一个专业的竞品价格数据收集系统需要持续监控机制。在部署 rotating proxy scrapy 时,您需要注意以下关键指标:
- 成功响应率(Success Rate): 200 OK 响应数占总请求数的比例。该比例应达到 95% 以上。如果该比例急剧下降,可能是您的代理列表被封禁或中间件配置不当。
- 平均响应时间(Latency): 中间代理可能会增加延迟。请设置合理的 DOWNLOAD_TIMEOUT 值(通常在 10 - 15 秒之间),以尽早剔除响应缓慢的代理,避免阻塞 Scrapy 的队列。
- 检测 HTML 结构变化: 有时电商平台不会封禁 IP,而是返回自定义错误页面或更改 DOM 结构。请编写输出数据验证代码(validation)。如果价格字段持续为 null,Spider 需要立即发送警报(alert)。
结论
自动监控竞品价格是帮助电商企业维持竞争优势并优化收入的战略举措。结合 proxy scrapy python 的异步数据收集能力与 rotating proxy scrapy 解决方案,彻底解决了反爬虫难题,帮助您稳定、准确地获取数据。
通过掌握 scrapy proxy middleware 的构建、选择正确的住宅代理类型以及优化请求策略,您就拥有了强大的数据基础设施,随时准备为数字时代的商业分析和自动定价方案提供支持。