
代理知识
Python 动态代理(Rotating Proxy)配置指南:高效网络爬虫防封 IP 实战

目录
1. 问题提出:为什么网络爬虫会导致 IP 被封禁?
数字时代,网络数据采集(Web Scraping)已成为企业、研究人员和开发者的必备工具。来自电子商务网站、社交网络或新闻门户的数据蕴含着巨大的商业价值。然而,当您进行大规模数据采集时,网站的防御系统很快就会识别出异常行为。
现代 Web 服务器配备了强大的防御机制,例如 WAF(Web 应用防火墙)、Cloudflare、Akamai 或 Imperva。其中最常见的控制方式之一是 Rate Limiting(请求频率限制)。当一个 IP 地址在短时间内发送过多的请求(requests)时,系统会自动将该 IP 列入可疑名单并采取应对措施:
- 返回错误代码 HTTP 429(Too Many Requests)或 HTTP 403(Forbidden)。
- 显示 CAPTCHA 验证码挑战(reCAPTCHA、hCaptcha、Turnstile)。
- 永久或临时封锁整个连接(IP Ban / IP Block)。
为了彻底解决这一问题,应用 Python 动态代理(rotating proxy)是隐藏服务器真实身份、模拟来自数千个真实用户访问的首选解决方案,从而确保数据抓取过程持续顺畅、不被打断。
2. 什么是动态代理(Rotating Proxy)?其工作原理是什么?
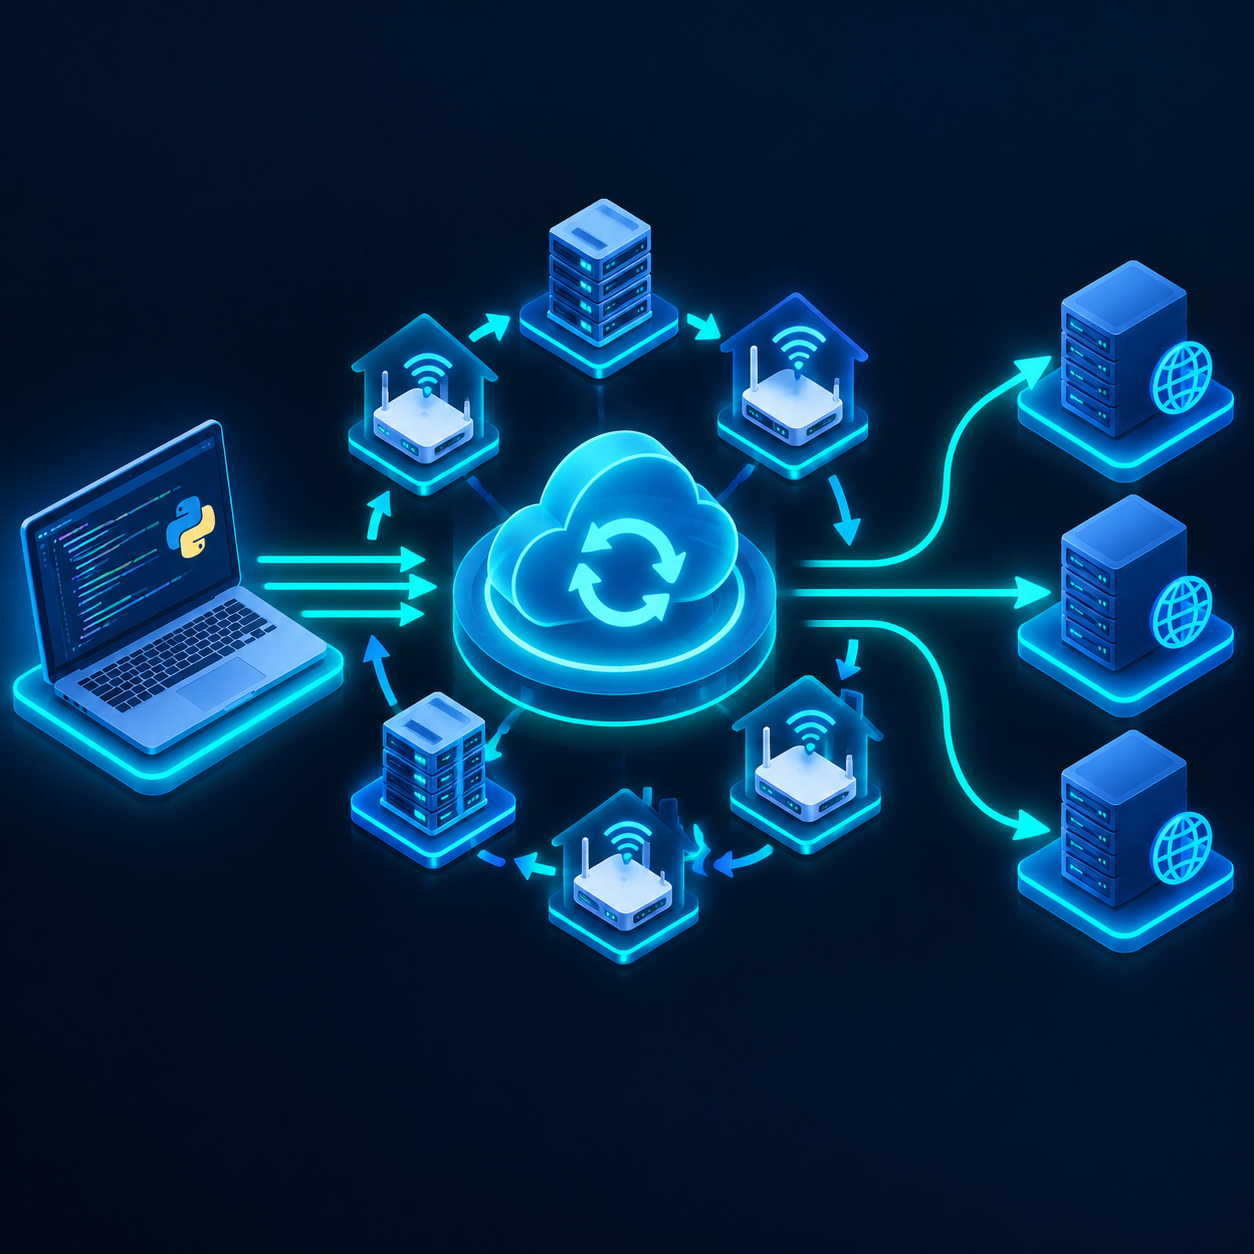 动态代理服务器在包含数百万个IP的资源池中自动轮换,使每次请求都来自全新的身份。
代理(Proxy)扮演着介于您的 Python 应用程序与目标网站之间的中间服务器角色。当您通过代理发送 HTTP 请求时,目标网站只能看到代理服务器的 IP 地址,而不是您的真实 IP 地址。
基础代理分类:数据中心 IP 与住宅 IP
在深入探讨 Python 代理配置技术之前,您需要区分两种常见的代理类型:
- 数据中心代理(Datacenter Proxy):由数据中心(如 AWS、DigitalOcean、Hetzner 等)生成的 IP。优点是速度极快、成本低廉。然而,主要缺点是很容易被反爬虫系统识别,因为该 IP 段不属于住宅互联网服务提供商(ISP)。
- 住宅代理(Residential Proxy):由网络运营商(如 VNPT、Viettel、AT&T、Comcast 等)分配给家庭用户的真实 IP 地址。这是可信度最高、极难被封锁的代理类型,但费用相对较高。
动态代理(Rotating Proxy)的工作机制
爬虫动态代理是一种在每次 HTTP 请求后或在特定时间间隔(几分钟)后自动更换 IP 地址的机制。与成千上万次请求共用一个 IP 不同,系统会在包含数百万个不同 IP 的资源池中持续轮换。因此,目标网站会将您的每次请求视为完全来自全新用户的访问,消除自动化疑虑,帮助您实现最佳的爬虫防封 IP效果。
3. 使用 Python Requests 配置动态代理指南
requests 库是 Python 中处理 HTTP 请求最标准、最流行的工具。以下是从基础到专业的 Python Requests 代理设置方法。
方法 1:在 Requests 中配置单个代理
为了理解其工作原理,首先您需要掌握如何在 Python 中将代理传递给 request 对象。requests 库支持一个名为 proxies 的参数,接收包含 IP 和端口(Port)信息的字典。
import requests
proxies = {
'http': 'http://10.10.1.10:8080',
'https': 'http://10.10.1.10:1080',
}
response = requests.get('https://httpbin.org/ip', proxies=proxies)
print(response.json())
如果您的代理需要用户名和密码验证,可以按照以下格式设置 URL 字符串:http://user:password@host:port。
方法 2:手动构建自定义动态代理轮换机制(Custom Proxy Rotator)
如果您拥有一份静态 IP 列表(Proxy list),可以使用 Python 的 random 库为每次请求随机选择一个 IP。
import requests
import random
proxy_list = [
'http://user:[email protected]:8080',
'http://user:[email protected]:8080',
'http://user:[email protected]:8080'
]
def get_with_random_proxy(url):
proxy = random.choice(proxy_list)
proxies = {'http': proxy, 'https': proxy}
try:
response = requests.get(url, proxies=proxies, timeout=5)
return response
except requests.exceptions.RequestException as e:
print(f'代理 {proxy} 发生错误: {e}')
return None
尽管这种手动解决方案很简单,但存在局限性:您必须亲自管理 IP 列表,自行过滤已失效的 IP(dead proxies),且列表规模通常受到限制。
方法 3:使用专业动态代理服务(推荐)
专业代理提供商(如 Bright Data、Oxylabs、Smartproxy、GeoSurf)提供单一接入点(Single Endpoint Gateway)。您只需连接到该 Endpoint,提供商的后端系统就会自动在每次请求时为您轮换 IP。
import requests
proxy_endpoint = 'http://username:[email protected]:7000'
proxies = {
'http': proxy_endpoint,
'https': proxy_endpoint
}
for i in range(5):
res = requests.get('https://httpbin.org/ip', proxies=proxies)
print(f'第 {i+1} 次 - 显示的 IP:', res.json()['origin'])
采用这种方法,您无需关心 IP 选择或处理失效 IP 的问题,从而使您的 Python 源代码更加简洁稳定。
4. 在 Scrapy 框架中配置动态代理
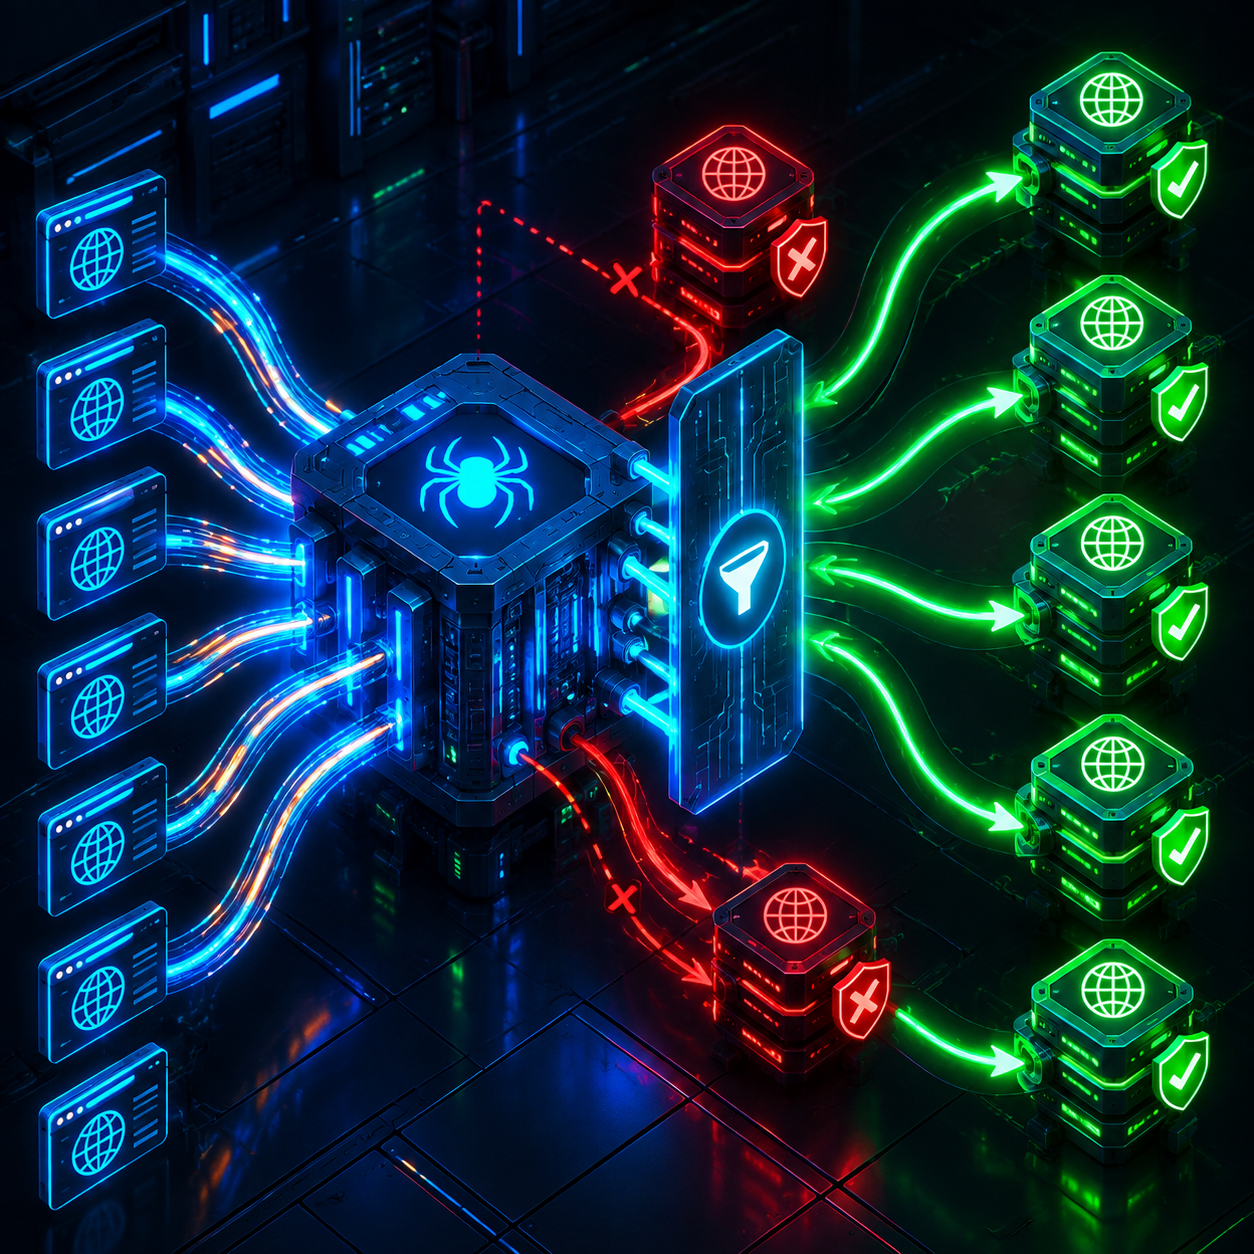 Scrapy中间件可自动监控代理状态,遇到封禁错误时自动切换至可用IP。
对于超大规模的数据采集项目,得益于异步架构(asynchronous),Scrapy 是首选框架。要在 Scrapy 中集成 Python 动态代理,我们可以使用扩展库 scrapy-rotating-proxies。
步骤 1:安装扩展库
使用 pip 命令安装扩展包:
pip install scrapy-rotating-proxies
步骤 2:配置 Scrapy 项目中的 settings.py 文件
打开 Scrapy 项目的 settings.py 文件,并添加以下 Middleware 配置行:
DOWNLOADER_MIDDLEWARES = {
'scrapy_rotating_proxies.middlewares.RotatingProxyMiddleware': 610,
'scrapy_rotating_proxies.middlewares.BanDetectionMiddleware': 620,
}
接下来,在 settings.py 中声明代理 IP 列表或动态代理 Endpoint 的路径:
ROTATING_PROXY_LIST = [
'http://user:[email protected]:8000',
'http://user:[email protected]:8000',
'http://user:[email protected]:8000',
]
scrapy-rotating-proxies 库会自动监控每个代理的状态。如果某个代理返回错误(403、429 或 Timeout),该库会自动将该 IP 标记为已封禁,并将请求重定向到另一个可用性更好的 IP。
5. 使用 Asyncio 和 Aiohttp 优化高速采集性能
当您每分钟需要发送成千上万个请求时,使用 requests(同步)可能会成为速度上的瓶颈。将 asyncio、aiohttp 与动态代理相结合,可以将爬虫速度提升数倍。
import asyncio
import aiohttp
proxy = 'http://user:[email protected]:8080'
urls = ['https://httpbin.org/ip' for _ in range(10)]
async def fetch(session, url):
try:
async with session.get(url, proxy=proxy, timeout=10) as response:
json_data = await response.json()
print('获取到的 IP:', json_data.get('origin'))
except Exception as e:
print('连接错误:', e)
async def main():
async with aiohttp.ClientSession() as session:
tasks = [fetch(session, url) for url in urls]
await asyncio.gather(*tasks)
asyncio.run(main())
6. 爬虫防封 IP 的最佳实践(Best Practices)
使用爬虫动态代理是必要条件,但不足以确保您的数据采集任务 100% 成功。现代反爬虫系统除了 IP 地址之外,还会分析许多其他因素。以下是帮助您提高成功率的实战经验:
6.1. 轮换 Header 和 User-Agent(User-Agent Rotation)
 除了更换IP,随机轮换User-Agent和完整的HTTP Header能大幅提升防封成功率。
User-Agent 是发送给服务器的标识浏览器和操作系统信息的字符串。如果成千上万个不同的 IP 发送相同的 Python 默认 User-Agent 字符串(例如:Python-requests/2.31.0),系统将立即识别出这是爬虫机器人。
- 使用 fake-useragent 库随机生成常见浏览器(桌面端和移动端的 Chrome、Firefox、Edge、Safari)的 User-Agent 列表。
- 确保其他重要的 HTTP Header(如 Accept-Language、Accept-Encoding、Sec-Ch-Ua)声明完整且逻辑一致。
6.2. 控制请求速度(Request Delays & Rate Control)
无延迟地连续发送请求会导致目标服务器过载且极易被察觉。在 Python 中使用 time.sleep(random.uniform(1, 3)) 在请求之间引入随机间隔(例如休息 1 到 3 秒)。
6.3. Cookie 和 Session 处理
许多网站通过 Cookie 追踪用户行为。使用动态代理时,建议清除 Cookie 或针对使用新 IP 的请求初始化新 Session,以避免系统将不同 IP 关联到同一个恶意会话中。
6.4. 使用 Selenium 或 Playwright 处理无头浏览器
对于使用 JavaScript(SPA、React、Vue)动态渲染内容的网站,仅发送简单 request 可能无法获取数据。您应该结合无头(Headless)模式下的 Playwright 或 Selenium,同时集成代理扩展或参数,既能模拟鼠标/滚动操作,又能安全地轮换 IP。
7. 如何选择最佳的动态代理提供商?
要选择合适的 Python 代理配置服务,您需要考量以下标准:IP 池规模、请求成功率、响应速度以及地理位置支持(Geo-targeting)。
- Bright Data (Luminati):全球规模最大的提供商,拥有超过 7200 万个住宅 IP。功能丰富,可靠度极高,但价格较昂贵,适合大型企业。
- Oxylabs:Bright Data 的直接竞争对手,以极快的响应速度和面向 Python 开发者的详细 API 文档而闻名。
- Smartproxy:性价比极高。易于设置,技术支持好,适合个人项目及中小企业。
- IPRoyal:提供不限时住宅代理套餐(流量永不过期),价格极具竞争力,对初学者非常友好。
8. 结语
掌握 Python 动态代理技术是决定任何大规模网络数据采集项目成败的关键因素。通过灵活结合住宅 IP 轮换机制、智能更换 User-Agent 以及合理控制请求频率,您将能够构建一个强大、持久运行的数据抓取系统,而无需担心爬虫防封 IP的屏障。
立即将本文中的代码示例应用到您的项目中,亲体验数据抓取速度与成功率带来的巨大提升吧!