
Hướng Dẫn Sử Dụng
使用 puppeteer-cluster 在 Puppeteer 中配置自动轮换代理池与故障转移指南

目录
代理池与故障转移机制在网络爬虫中的重要性
在使用 Puppeteer 部署大规模数据采集系统时,依赖单一网络地址通常会导致连接中断或受到目标服务器的流量限制。为了保持工作流程的连续性与稳定性,必不可少的解决方案是集成专用的 puppeteer 代理池(proxy pool puppeteer)基础设施。
该基础设施不仅能为每个任务轮换更改连接地址,还需要具备自我修复机制,即网络爬虫代理故障转移(proxy failover web scraping)。当中介地址出现故障、响应缓慢或完全停止工作时,系统必须能够自动识别、剔除故障节点,并使用另一个地址重试请求,以确保所采集数据的完整性。
puppeteer-cluster 库概述
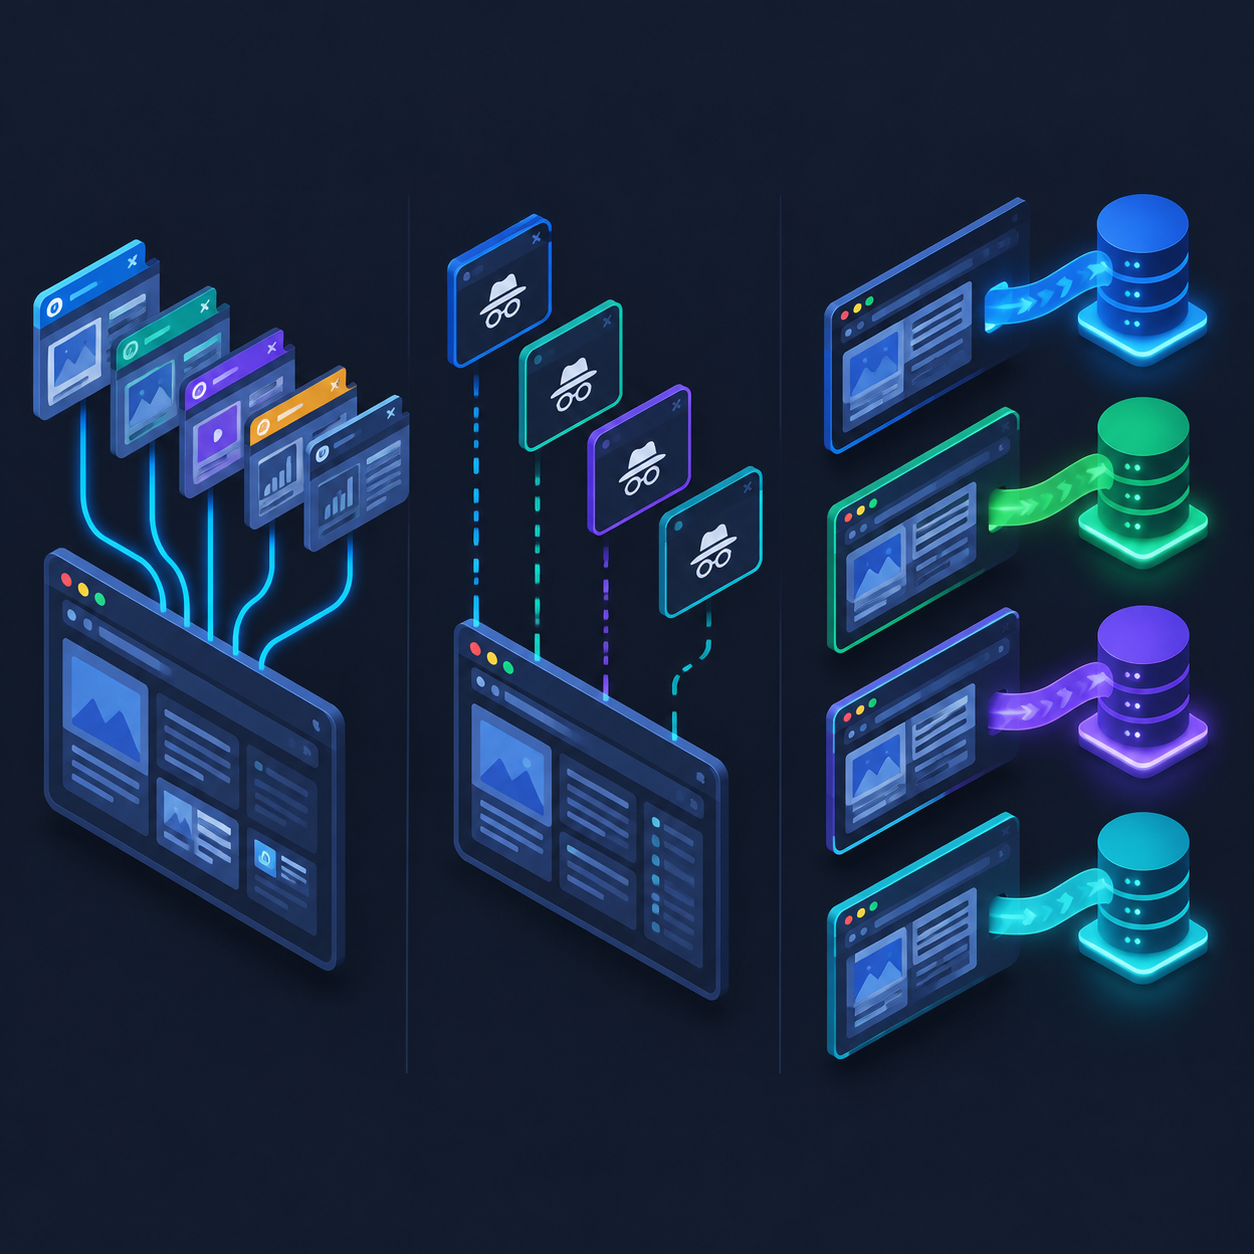
Puppeteer 是一款用于控制无头浏览器的强大工具,但同时管理多个进程的生命周期会消耗大量的硬件资源。puppeteer-cluster 库的诞生正是为了解决调度问题,它允许通过灵活的会话管理模式来分配并发任务。
该库提供的主要并发模式包括:
- Cluster.CONCURRENCY_PAGE:共享同一个浏览器进程并通过标签页进行分支。这种模式节省资源,但无法在进程级别配置单独的网络参数。
- Cluster.CONCURRENCY_CONTEXT:利用同一浏览器中的隐身上下文。该方法支持隔离 Cookie 和会话,但仍存在启动网络参数方面的限制。
- Cluster.CONCURRENCY_BROWSER:为每个任务启动一个独立的浏览器进程。这是集成 puppeteer-cluster 代理的最佳模型,因为它允许从打开浏览器的阶段就应用单独的代理服务器参数。
为 puppeteer-cluster 设计代理池架构
为了构建具有容错能力的 puppeteer 轮换代理配置系统,程序结构需要拆分为两个主要组件:代理资源管理层(Proxy Pool Manager)和任务调度层(Cluster Runner)。
1. 设计灵活的代理池管理器
地址列表管理器需要掌握每个连接点的运行状态,支持基于轮询算法获取地址,并记录网络故障以及时临时隔离无响应的地址。
专业 Proxy Manager 类的关键属性包括可用地址列表、轮换队列、临时黑名单以及连续失败次数计数器。
2. 在 puppeteer-cluster 中选择合适的执行模式
由于 Chromium 的网络参数标志通常需要在进程启动时传入,因此使用独立浏览器运行模式是一项强制要求,以便为每个独立会话更改连接地址,而不影响其他并发任务。
分步实施指南
以下是构建全面请求分发和故障转移解决方案的具体编程方法。
步骤 1:安装依赖包
系统需要安装运行环境和自动化控制库:
需要通过系统的包管理器安装 puppeteer 和 puppeteer-cluster 库,以开始编写源代码。
步骤 2:构建代理调度及错误处理类
该类负责为每个任务分配代理服务器,并接收有关连接运行状态的反馈:
- 轮换获取算法:获取列表头部的元素,供任务使用,如果连接稳定则推回列表末尾。
- 标记失败(Mark Failed):当任务遇到超时或连接中断故障时,该接入点将被移至检查队列或暂时从轮换池中移除。
- 定期恢复:提供一种机制,在经过设定的等待时间后,自动将已恢复的地址重新添加回活动组。
步骤 3:将代理集成到 Cluster 初始化流程中
在初始化 Cluster 对象时,需要干预浏览器的启动参数以分配相应的代理地址。每当调度一个新任务时,系统都会向 Proxy Manager 请求一个新的连接配置。
这确保了创建的每个独立进程都在各自独立的网络传输路由上运行,从而分散风险并增强整个数据流的整体稳定性。
步骤 4:设置自动故障转移机制
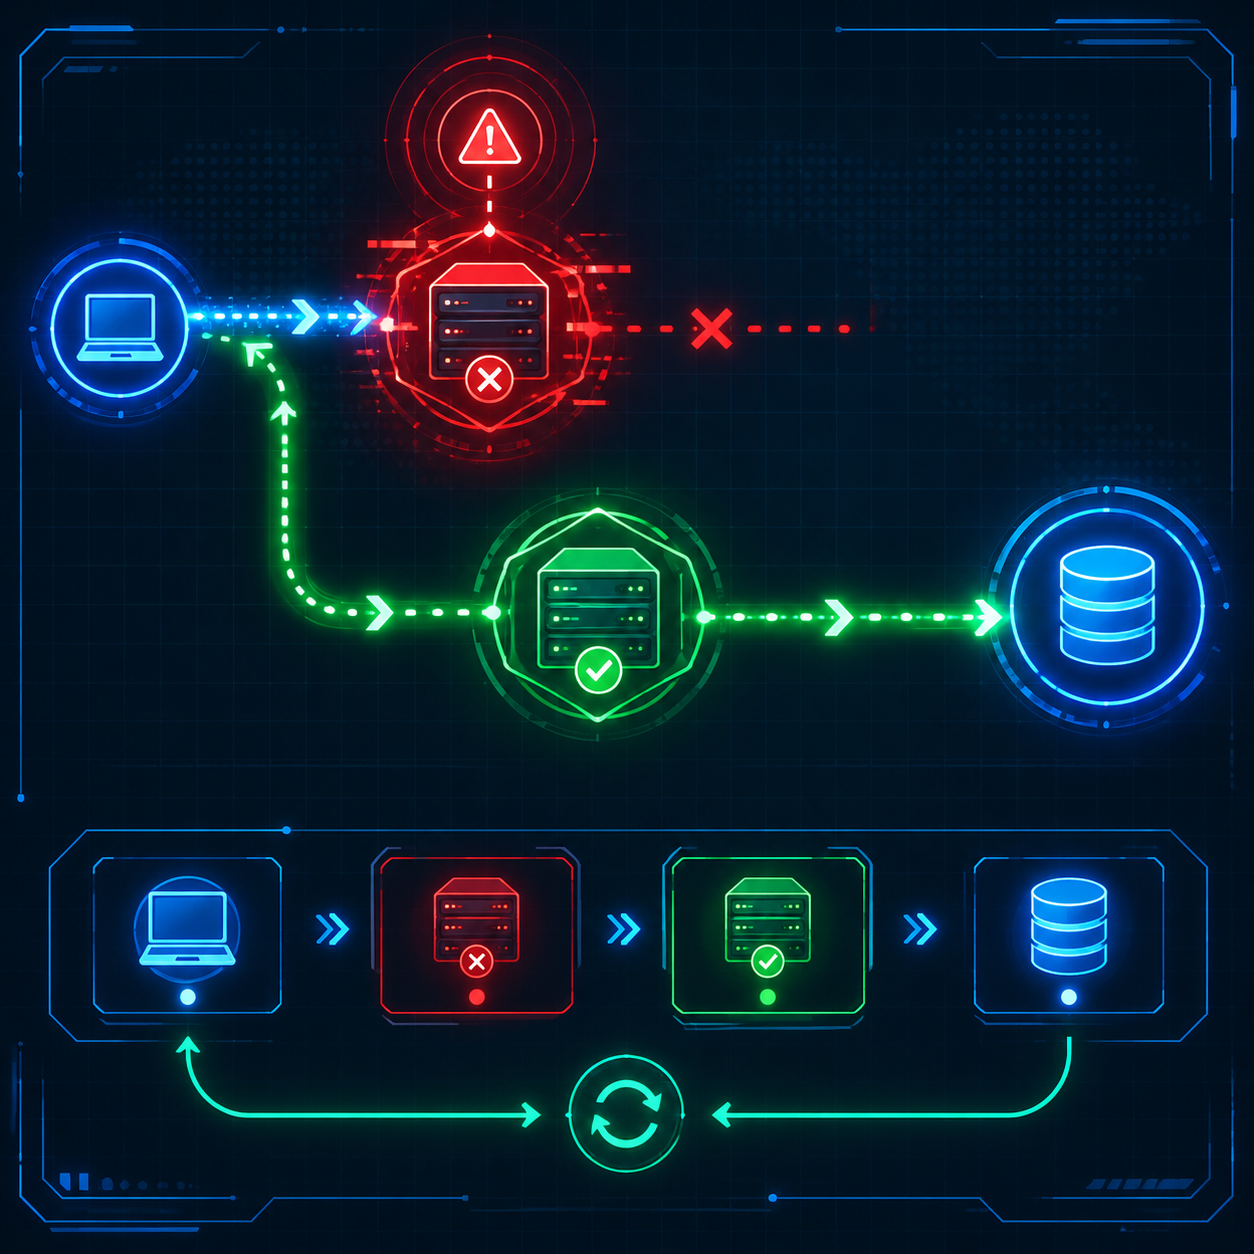
当任务的执行代码块抛出与网络基础设施相关的异常时,将触发故障转移机制。标准处理流程包括:
- 使用异常控制结构捕获主执行代码块中的错误。
- 通知代理管理器当前地址已发生故障。
- 将工作重新委派到集群队列中,以使用其他地址重试。
- 为每个任务设置最大重试阈值,以避免在整个网络资源出现故障时陷入无限循环。
在 Cluster 环境中处理代理身份验证
专业的代理服务解决方案通常需要用户名和密码身份验证机制。在这种情况下,仅通过命令行参数提供 IP 地址和服务端口是不够的。
在每个任务的工作处理函数中,需要在新页面打开后立即调用页面的身份验证方法以加载相应的凭据信息。这确保了在向目标服务器发送请求之前,访问会话已获得完全授权。
维持系统稳定的重要注意事项
持续运行大规模信息采集系统需要严格的技术控制标准:
- 硬件资源管理:启动多个浏览器的模式会消耗大量内存和处理性能。需要密切监控服务器性能以设置合适的并发执行线程数,避免出现资源拥堵现象。
- 合理的超时设置:建立严格的连接和资源加载超时阈值。如果某个代理节点响应过慢,系统应主动断开连接,将处理权让给其他更可行的地址。
- 控制连接列表质量:定期从存储目录中筛选剔除无响应的地址,以优化任务队列的执行时间。
结论
将 puppeteer-cluster 代理解决方案与轮换及故障转移管理结构相结合,有助于构建专业、稳健且高扩展性的数据采集系统。通过合理调度资源并主动处理网络连接风险,自动化任务将能够顺畅运行,充分满足实际环境中复杂的数据处理需求。