
Hướng Dẫn Sử Dụng
使用 Prometheus Blackbox Exporter 和 Alertmanager 监控 HTTP 代理

目录
为什么代理仍在运行,应用却无法连接?
代理进程正在运行,并不意味着应用能够使用该代理。服务可能仍在监听网络端口,却无法访问互联网、出现身份验证错误,或无法建立通往 HTTPS 目标的隧道。
因此,HTTP 代理监控需要检查完整的请求路径:从监控主机到代理,再从代理到目标服务器,并确认收到有效响应。单纯检查端口无法全面反映这一过程。
Prometheus Blackbox Exporter 从外部执行探测,Prometheus 采集结果,而 Alertmanager 在满足告警条件时路由通知。正确组合这些组件,有助于发现不可用情况并跟踪延迟趋势。
监控架构与结果含义
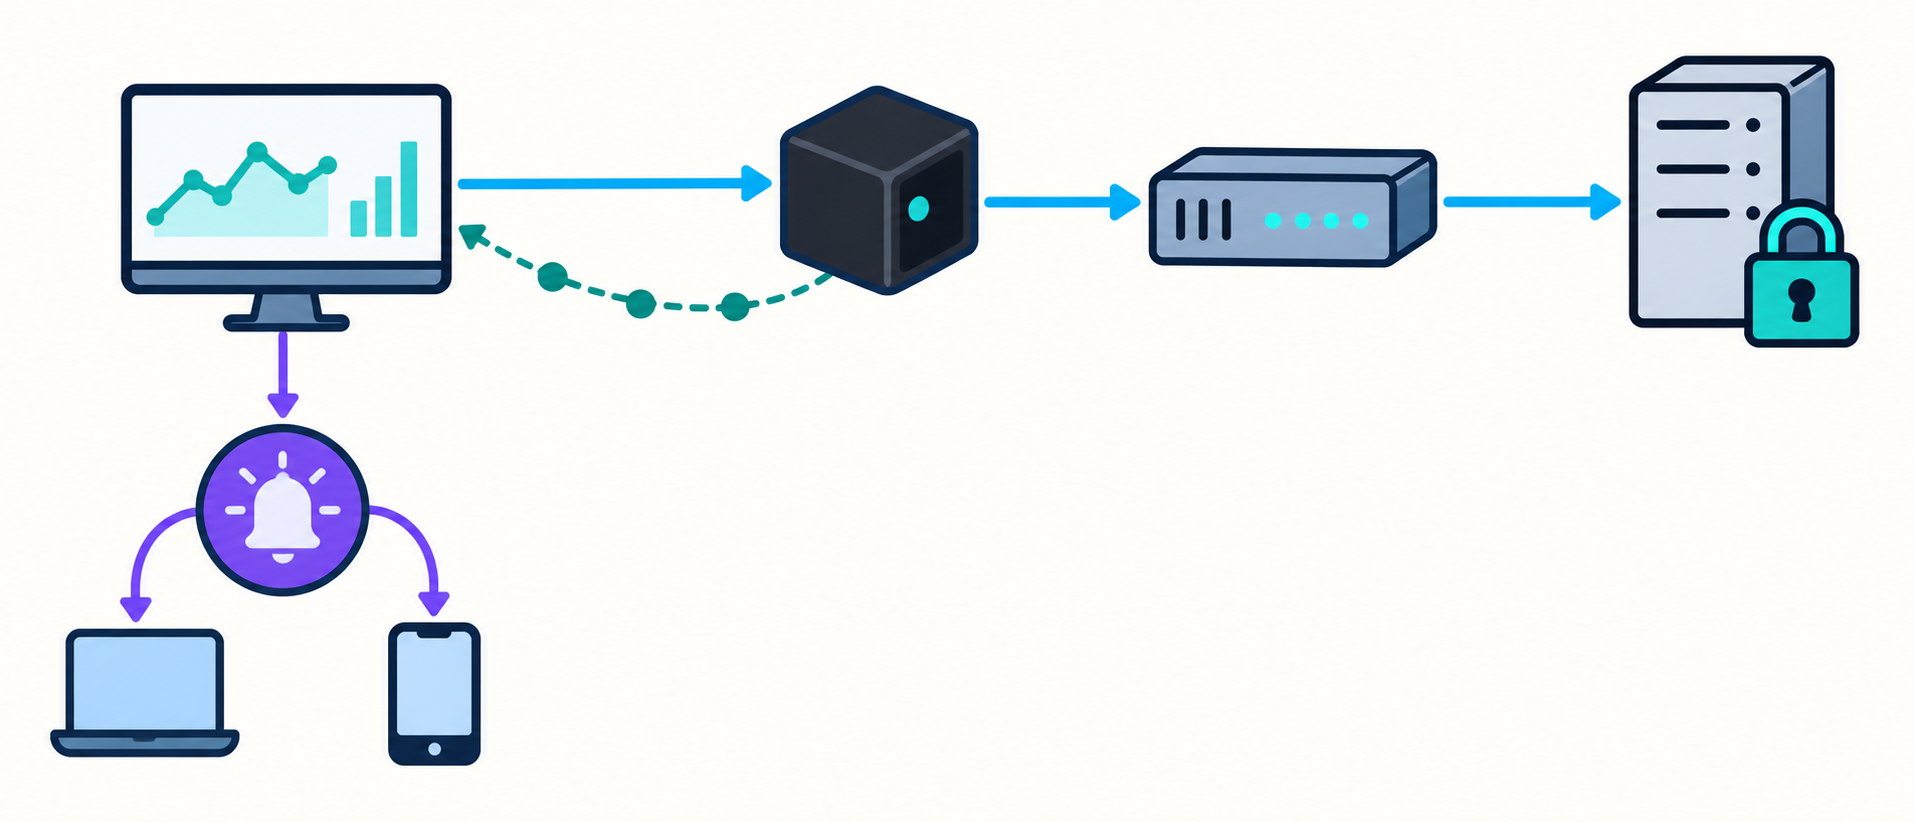
检查流程从 Prometheus 调用 Blackbox Exporter 的 /probe 端点开始。Exporter 使用已配置的 HTTP 模块,通过代理向测试 URL 发送请求,然后返回指标。
- Blackbox Exporter: 执行 HTTP 请求并评估响应。
- Prometheus: 存储时间序列、执行查询表达式并评估告警规则。
- Alertmanager: 对告警进行分组、路由通知,并处理维护期间的静默。
- 测试端点: 提供稳定响应,以确认经过代理的通信路径正常工作。
需要区分代理可用性检查与进程检查。这种探测反映的是所选完整路径的可用性。探测失败时,原因可能出在代理、DNS、网络或目标服务器。
准备测试端点与 exporter 部署位置
选择可控的测试目标
建议使用由组织管理的端点,其响应应当简单,且不依赖交互式登录。避免使用频繁重定向、内容不断变化或依赖大量后端服务的首页。
如果应用主要通过 HTTP 代理访问 HTTPS,请使用 HTTPS 目标。这样,探测将涵盖 CONNECT 隧道的建立以及与目标服务器的 TLS 连接,更贴近应用的实际行为。
还可以增加独立的测试目标以进行对照。如果只有一个目标失败,而其他目标仍正常工作,应先考虑目标端故障,再判断代理是否失去连接。
将 exporter 部署在合适的网络区域
Exporter 到代理的访问路径应与被监控应用相似。从管理网络发起的探测成功,并不能保证生产网络中的应用也能连接。
添加网络区域或探测位置标签,以区分结果。同时,应限制对 exporter 的访问并控制出站流量,因为 probe 端点能够向指定地址发起请求。
为 HTTP 代理配置 Prometheus Blackbox Exporter
创建使用代理的 HTTP 模块
在 Blackbox Exporter 配置中,声明带有 prober: http 的模块。在 http 部分中,将 proxy_url 设置为代理地址,例如 http://proxy.internal:3128。此地址仅供示例,需替换为实际信息。
Prometheus 通过 module 参数选择模块。而 target 参数必须是需要通过代理访问的目标 URL,而不是代理地址。混淆这两个地址,可能导致探测偏离预期目标。
- method: 选择适合测试端点的请求方法。
- valid_status_codes: 如果需要使用不同于默认值的响应码,可在此声明允许的响应码。
- follow_redirects: 决定是否跟随重定向。
- timeout: 限制探测完成所需的时间。
- fail_if_body_not_matches_regexp: 可用于确认响应包含预期内容。
如果端点返回专用的确认字符串,检查响应内容有助于避免将中间环节返回的错误页面误判为成功。不过,不应依赖经常变化的内容。
处理身份验证信息与 TLS
应区分代理身份验证与目标服务器身份验证。用于目标端的 HTTP 身份验证字段不会自动替代代理身份验证信息。请确认当前使用的 exporter 版本所支持的机制。
不要将密码放入 Prometheus 标签、target URL 或通知内容中。如果配置中包含身份验证信息,应限制读取权限、做好密钥管理,并避免将其存入代码仓库。
对于 HTTPS 目标,应保持证书验证开启;使用内部证书时,应配置适当的 CA。关闭 TLS 验证会降低探测的价值,并可能掩盖应用实际遇到的错误。
配置 Prometheus 采集探测结果
创建独立的抓取任务,将 metrics_path 设置为 /probe,并在 params 中传入模块名称。该任务的 target 为测试 URL;exporter 地址则通过标签重写引入。
常见的标签重写顺序如下:
- 将原始 __address__ 转存到 __param_target,使 exporter 获得目标 URL。
- 将 __param_target 复制到 instance,以便在结果中识别目标。
- 使用 Blackbox Exporter 的地址覆盖 __address__,确保 Prometheus 调用正确的服务。
添加稳定的标签,例如 proxy_id、environment 和 region。存在多个代理时,可以创建对应模块,然后通过任务配置或标签重写选择模块。描述代理的标签不会自动更改模块的 proxy_url。
模块的超时时间必须与 scrape_timeout 相匹配,同时为 exporter 返回结果预留时间。抓取间隔和告警条件的持续时间应根据运维需求选择,而不是直接套用统一阈值。
正确解读可用性与延迟指标
区分 probe_success 与 up
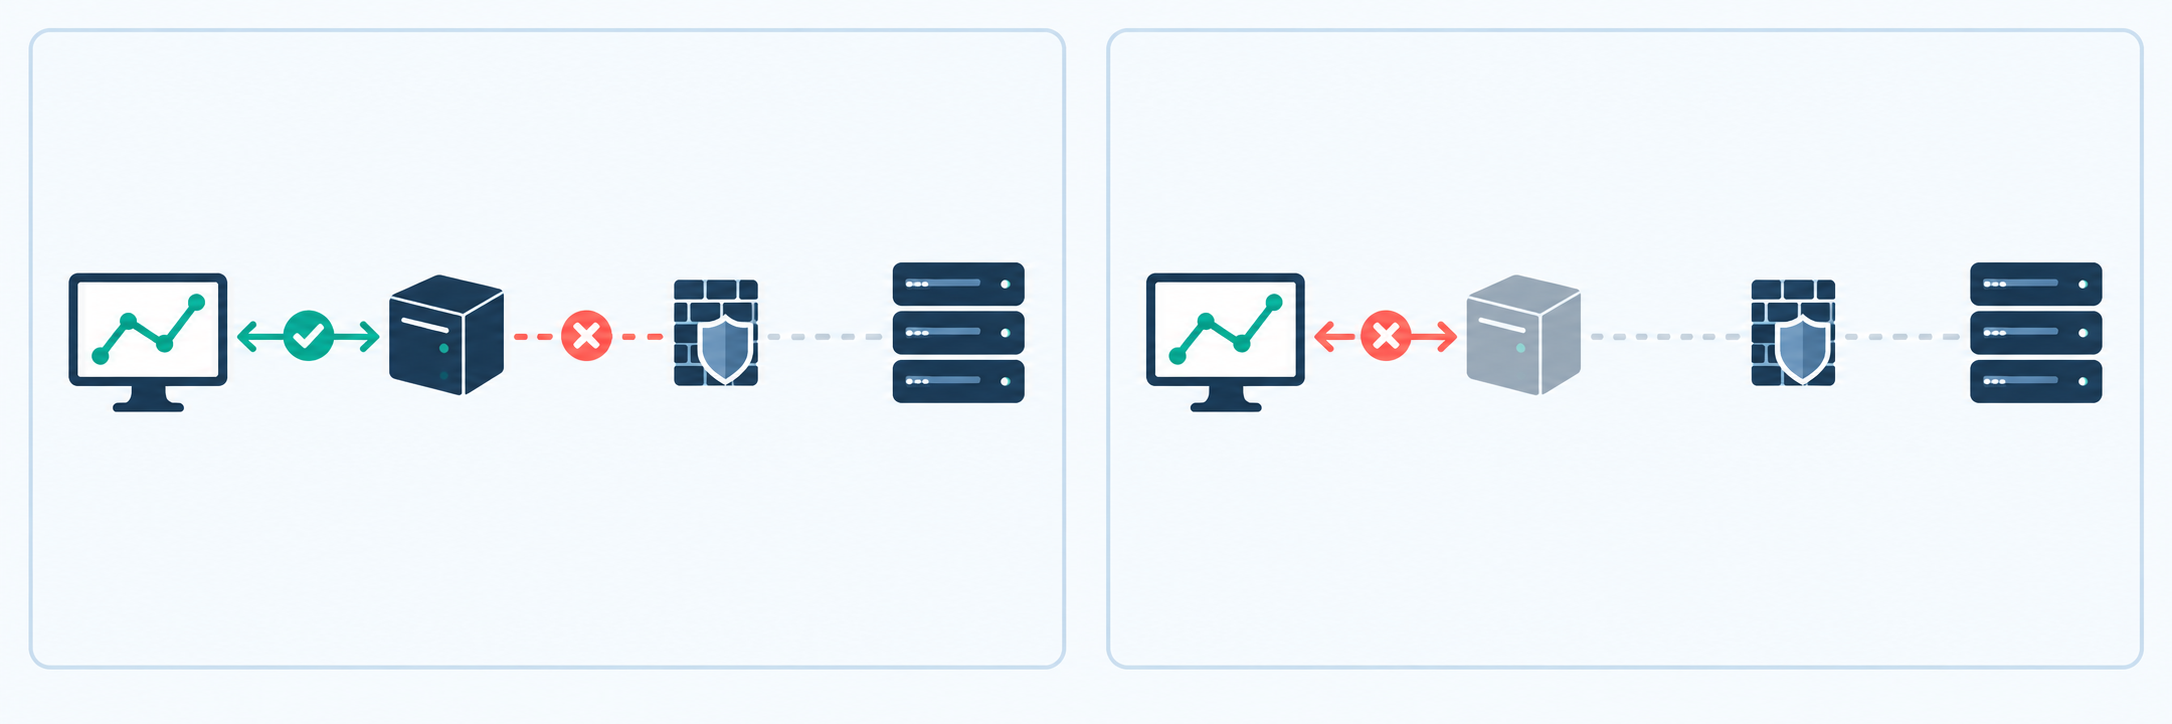
probe_success 表示探测是否满足成功条件。表达式 probe_success{job="blackbox-http-proxy"} == 0 用于筛选失败的探测。
相比之下,up 反映 Prometheus 是否成功抓取 exporter 端点。即使通过代理发起的请求失败,exporter 仍可能正常返回指标。因此,只监控 up 会遗漏经过代理的通信路径上的故障。
理解延迟测量的局限
probe_duration_seconds 表示执行探测的总耗时。它是衡量通过代理完成请求所需时间的有用指标,但并不代表代理自身的延迟。
probe_http_duration_seconds 提供 exporter 记录的各个 HTTP 阶段耗时。使用代理时,尤其是使用 CONNECT 时,不应默认每个阶段都与某个独立网络组件完全对应。需要结合当前运行版本的实现方式和诊断日志进行核对。
应将成功探测与失败探测的延迟分开查看。快速被拒绝的请求耗时很低,但这并不是服务质量良好的信号。分析趋势时,应始终将延迟图表与成功状态放在一起查看。
设置代理连接中断告警
构建带有确认时间的告警条件
基于表达式 probe_success{job="blackbox-http-proxy"} == 0 创建告警规则。添加 for 字段,要求故障状态持续存在一段时间后,才进入 firing 状态。
确认时间需要在检测速度与容忍短暂故障之间取得平衡。应根据抓取周期、代理的重要程度以及实际运维数据进行选择。
在注解中,应准确描述为通过代理的探测失败,而不是断言代理进程已经停止。通知应包含代理、环境、测试目标以及初步处理指引。
在失去可观测性时告警
为 up{job="blackbox-http-proxy"} == 0 创建独立告警。这种情况表示 Prometheus 无法获取探测结果,并不能直接证明代理发生故障。
如果 target 从配置或服务发现中被移除,时间序列可能直接消失,而不是变成表示故障的值。对于已知标签集,可以使用 absent 或 absent_over_time;存在多个代理时,需要与预期代理清单进行对照,才能发现各个缺失对象。
通过 Alertmanager 路由通知
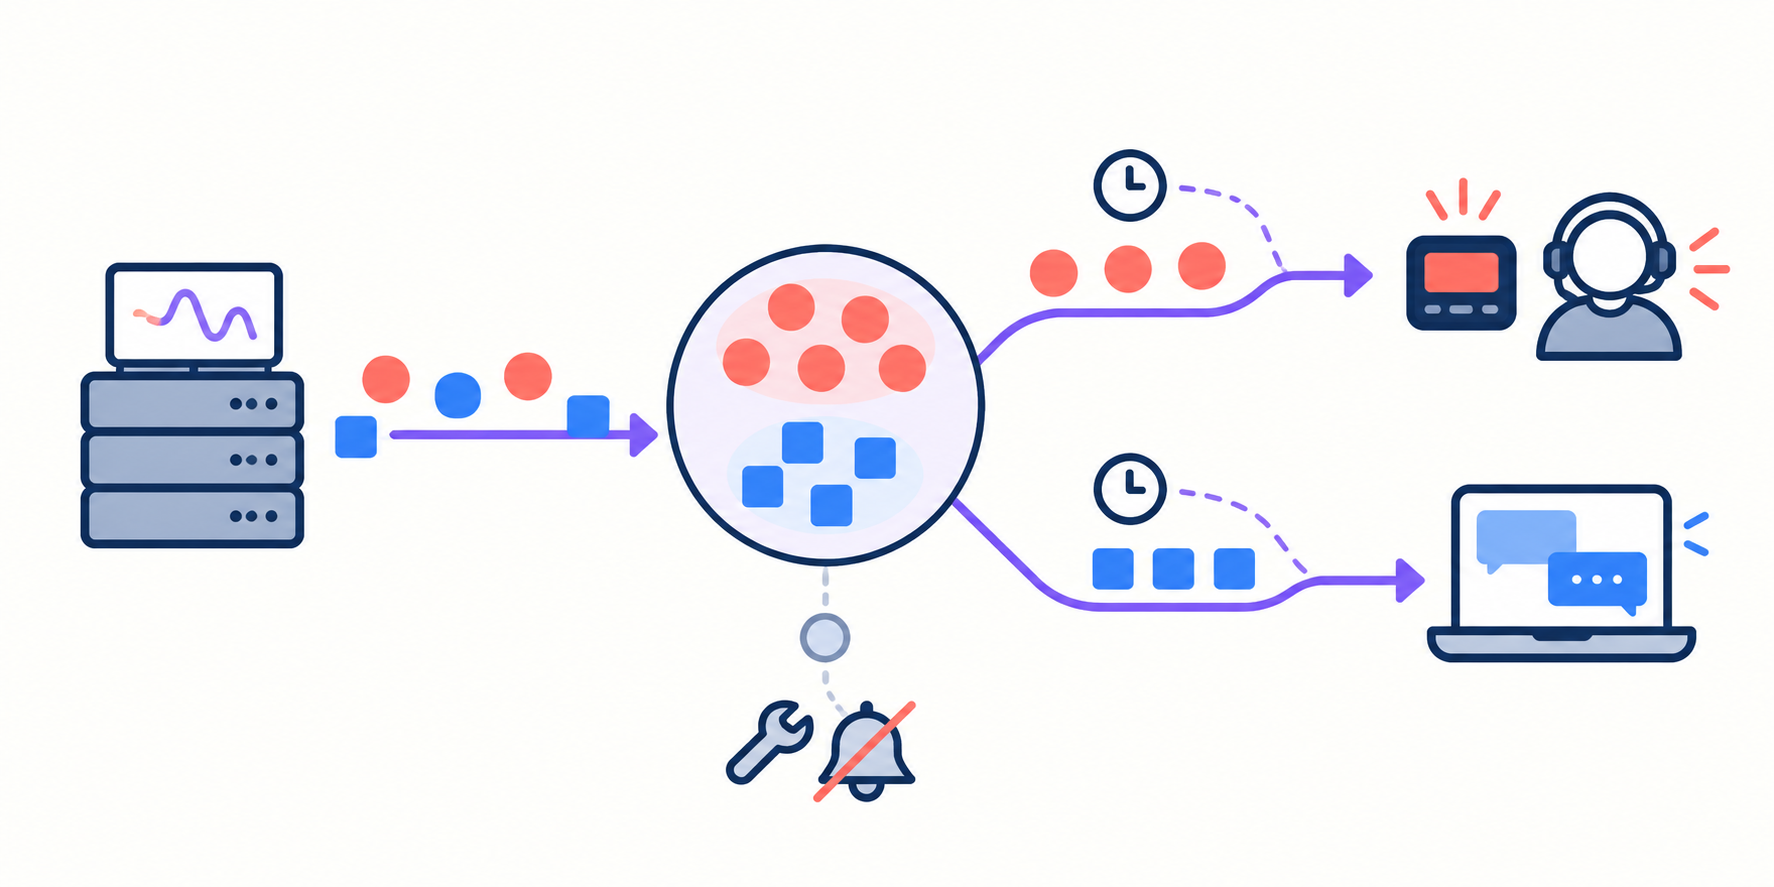
Prometheus 评估规则并将告警发送至 Alertmanager。Alertmanager 本身不执行探测;它的职责是对告警进行分组、路由,并将通知发送给已配置的接收器。
可以按告警名称、代理和环境分组,以保留足够的上下文。将生产环境的通知路由至运维值班团队,将测试环境的通知路由至紧急程度较低的渠道。
- group_wait: 发送该组首条通知前的等待时间。
- group_interval: 控制组内更新通知的发送间隔。
- repeat_interval: 决定何时再次提醒仍未解除的告警。
对计划内维护使用静默,并在接收器支持的情况下启用恢复通知。只有在依赖关系明确时才应用抑制规则;不应自动将所有探测错误都视为 exporter 故障的结果。
投入运行前进行测试
重新加载之前,先使用适当的工具检查配置和规则的语法。然后,在获得授权的环境中逐一测试各种场景,以验证从检测到通知的完整流程。
- 阻断 exporter 到代理的连接,确认探测失败。
- 使用无效身份验证信息进行测试,并检查通知是否妥善保护敏感信息。
- 使测试端点不可用,以区分目标故障与代理故障。
- 停止 exporter,以测试监控数据缺失告警。
- 恢复服务,并确认 resolved 状态被发送至正确的位置。
诊断过程中,可以在调用 probe 时添加 debug=true 参数,以查看详细处理信息。仅应在受控范围内使用,并在共享日志前检查其中的敏感数据。
总结
有效的 HTTP 代理监控需要结合端到端探测、准确的指标解读以及经过验证的告警流程。Prometheus Blackbox Exporter 提供可用性和请求执行耗时数据;Prometheus 与 Alertmanager 则将这些数据转化为运维信号。
最重要的是区分经过代理的通信路径故障、端点故障与监控系统故障。当配置准确反映应用的实际请求路径时,代理连接中断告警就能提供清晰的上下文,并更有效地支持故障排查。