
Kiến Thức Proxy
Hướng Dẫn Cấu Hình Rotating Proxy Với Framework Scrapy Để Theo Dõi Giá Đối Thủ Trên Sàn Thương Mại Điện Tử

Mục lục
Đặt Vấn Đề: Tại Sao Theo Dõi Giá Đối Thủ Lại Quyết Định Sự Tồn Tại Trên Sàn Thương Mại Điện Tử?
Trong bối cảnh thị trường thương mại điện tử phát triển bùng nổ, giá cả đã trở thành một trong những yếu tố cạnh tranh sống còn. Các sàn thương mại điện tử lớn như Shopee, Lazada, Tiki hay Amazon luôn diễn ra cuộc đua về giá từng giờ, thậm chí từng phút. Doanh nghiệp nào nắm bắt được biến động giá của đối thủ nhanh nhất sẽ có lợi thế tối đa trong việc điều chỉnh giá bán tự động (dynamic pricing), tối ưu hóa chiến dịch quảng cáo và bảo vệ biên lợi nhuận.
Tuy nhiên, việc thu thập dữ liệu giá trên quy mô lớn gặp phải rào cản kỹ thuật rất lớn từ các hệ thống phòng thủ anti-bot. Các sàn thương mại điện tử áp dụng nhiều cơ chế phức tạp như giới hạn tần suất truy cập (rate limiting), chặn IP, yêu cầu giải CAPTCHA hoặc kiểm tra dấu vết trình duyệt. Nếu bạn chỉ sử dụng một địa chỉ IP duy nhất để truy cập hàng ngàn trang sản phẩm trong thời gian ngắn, IP của bạn sẽ bị cấm (block) ngay lập tức. Đây chính là lý do vì sao việc kết hợp proxy scrapy python và kỹ thuật rotating proxy scrapy trở thành giải pháp tiêu chuẩn chuyên nghiệp cho bài toán crawl gia thương mại điện tử.
Vai Trò Của Rotating Proxy Trong Việc Crawl Dữ Liệu Thương Mại Điện Tử
Proxy đóng vai trò là một máy chủ trung gian đứng giữa ứng dụng thu thập dữ liệu (Scrapy Spider) và website đích. Khi sử dụng proxy, địa chỉ IP thực của máy chủ crawl sẽ được ẩn đi, và website đích chỉ ghi nhận IP của máy chủ proxy.
Tuy nhiên, nếu chỉ sử dụng một proxy tĩnh (Static Proxy), nguy cơ bị phát hiện và cấm truy cập vẫn rất cao khi gửi hàng loạt request. Kỹ thuật rotating proxy scrapy (xoay vòng IP) sẽ tự động thay đổi địa chỉ IP outbound cho mỗi yêu cầu HTTP hoặc sau một khoảng thời gian nhất định. Điều này mang lại nhiều lợi ích vượt trội:
- Vượt qua giới hạn tần suất (Rate Limit): Phân phối hàng ngàn request đến từ hàng trăm địa chỉ IP khác nhau, khiến hệ thống giám sát của website coi đó là lượng truy cập tự nhiên từ nhiều người dùng độc lập.
- Tránh bị cấm IP diện rộng: Nếu một IP bị phát hiện và tạm khóa (trả về lỗi HTTP 403 Forbidden hoặc 429 Too Many Requests), hệ thống sẽ ngay lập tức loại bỏ IP đó và chuyển sang một IP sạch khác để tiếp tục công việc mà không làm gián đoạn toàn bộ tiến trình.
- Thu thập dữ liệu theo vị trí địa lý (Geo-targeting): Nhiều sàn TMĐT hiển thị giá và chi phí vận chuyển khác nhau tùy theo khu vực địa lý của người mua. Rotating proxy cho phép bạn chọn IP tại từng tỉnh thành hoặc quốc gia cụ thể để thu thập mức giá chính xác nhất.
Tổng Quan Về Kiến Trúc Scrapy Proxy Middleware
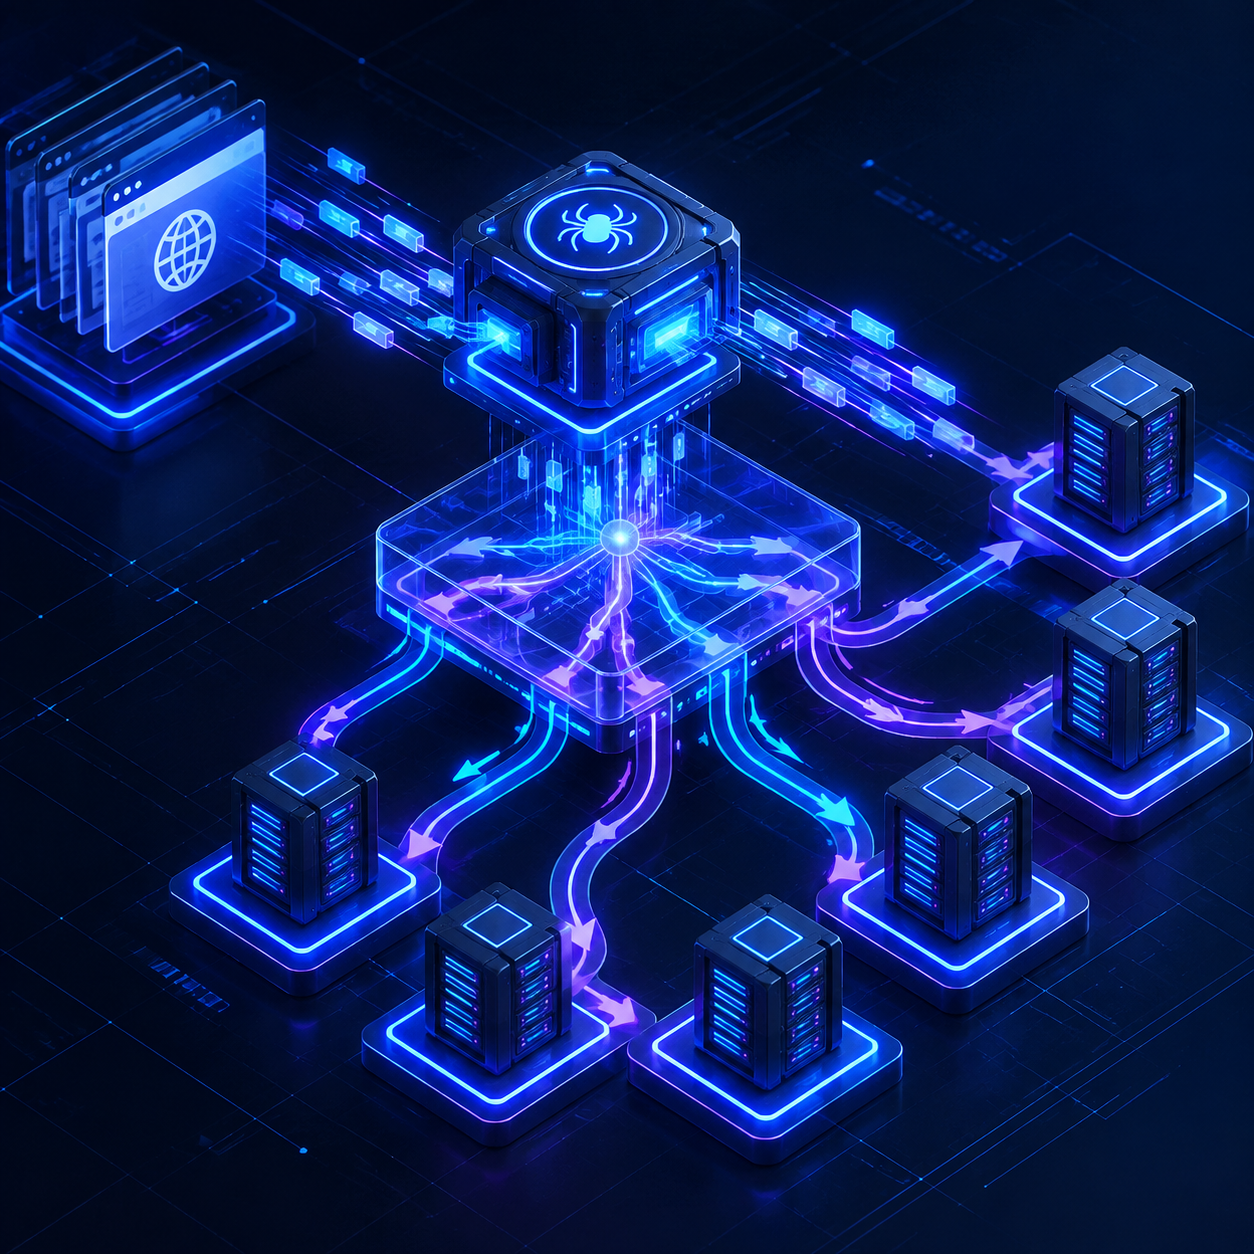 Cấu trúc Downloader Middleware trong Scrapy đóng vai trò cầu nối xử lý request và luân chuyển IP trước khi kết nối tới server đích.
Scrapy là một framework mạnh mẽ viết bằng Python dành riêng cho tác vụ web scraping. Cốt lõi trong việc quản lý và luân chuyển IP trong Scrapy nằm ở thành phần scrapy proxy middleware (Downloader Middleware).
Downloader Middleware nằm ở vị trí trung gian giữa Downloader Engine và Request/Response pipeline. Mỗi khi một Request được khởi tạo từ Spider, nó sẽ đi qua các Downloader Middleware trước khi gửi đến internet. Tại đây, chúng ta có thể can thiệp vào Request header, gán địa chỉ proxy, thay đổi User-Agent, hoặc xử lý các ngoại lệ trả về từ server target.
Hướng Dẫn Chi Tiết Cấu Hình Rotating Proxy Với Scrapy
Bước 1: Chuẩn bị môi trường và dự án Scrapy
Đầu tiên, bạn cần đảm bảo đã cài đặt Python (từ phiên bản 3.8 trở lên) và môi trường ảo (virtualenv). Tiến hành cài đặt framework Scrapy và thư viện hỗ trợ bằng lệnh terminal chuẩn.
Sau khi tạo dự án Scrapy mới, bạn sẽ có cấu trúc thư mục tiêu chuẩn bao gồm các tệp tin quan trọng như settings.py, middlewares.py và thư mục spiders/.
Bước 2: Lựa chọn phương án triển khai Rotating Proxy
Hiện nay có hai phương pháp chính để tích hợp rotating proxy scrapy vào dự án Python của bạn:
- Sử dụng gói thư viện sẵn có (scrapy-rotating-proxies): Phù hợp cho các danh sách proxy tự quản lý (List of IP:Port). Thư viện này tự động theo dõi hiệu suất của từng IP, tạm dừng các IP bị lỗi hoặc bị block và ưu tiên các IP hoạt động tốt.
- Sử dụng Dịch vụ Rotating Proxy Backend (Proxy Provider Endpoint): Các nhà cung cấp proxy chuyên nghiệp (như Bright Data, Oxylabs, Smartproxy) cung cấp một endpoint duy nhất (ví dụ: proxy.example.com:8080). Mỗi request gửi qua endpoint này sẽ tự động được xoay sang một IP mới ở phía server của nhà cung cấp. Phương pháp này đơn giản và hiệu quả nhất cho các dự án quy mô cực lớn.
Bước 3: Xây dựng Custom Scrapy Proxy Middleware
Để kiểm soát tối đa tiến trình xử lý request, việc viết một scrapy proxy middleware tùy chỉnh là giải pháp được các kĩ sư dữ liệu ưu tiên. Dưới đây là luồng logic cốt lõi cần xây dựng trong tệp middlewares.py:
Trong phương thức process_request, chúng ta trích xuất một địa chỉ proxy từ danh sách khả dụng hoặc từ dịch vụ xoay IP, sau đó gán trực tiếp vào thuộc tính request.meta['proxy']. Trường hợp proxy yêu cầu xác thực bằng Username và Password, thông tin đăng nhập cần được mã hóa chuẩn Base64 và gán vào header Proxy-Authorization.
Trong phương thức process_response, middleware sẽ kiểm tra mã trạng thái HTTP trả về từ sàn thương mại điện tử. Nếu gặp các mã lỗi nghi ngờ bị chặn như 403, 429, 503 hoặc xuất hiện trang CAPTCHA, middleware sẽ tiến hành vô hiệu hóa IP hiện tại, đổi sang IP mới và đưa Request đó quay trở lại hàng chờ (scheduler) để thử lại (retry).
Bước 4: Thiết lập cấu hình trong settings.py
Tệp settings.py đóng vai trò trung tâm điều khiển cho toàn bộ crawler. Để tối ưu hóa việc crawl gia thương mại điện tử và tích hợp proxy mượt mà, bạn cần cập nhật các thông số sau:
Kích hoạt Custom Middleware bằng cách khai báo trong thuộc tính DOWNLOADER_MIDDLEWARES với một chỉ số thứ tự (priority) phù hợp, thường là khoảng từ 300 đến 750 để đảm bảo nó chạy trước các middleware xử lý nén dữ liệu hoặc cookie.
Tắt cơ chế quản lý Cookie (COOKIES_ENABLED = False) trừ khi bắt buộc phải đăng nhập. Việc gửi cookie cố định đi kèm với các IP khác nhau là một trong những dấu hiệu hàng đầu khiến hệ thống anti-bot phát hiện hành vi bất thường.
Điều chỉnh các thông số về concurrency và delay. Khi đã có hệ thống rotating proxy scrapy chất lượng cao, bạn có thể gia tăng CONCURRENT_REQUESTS để tăng tốc độ thu thập. Tuy nhiên, vẫn nên đặt một khoảng DOWNLOAD_DELAY nhỏ ngẫu nhiên (AutoThrottle Extension) để giảm tải áp lực cho máy chủ đích và tránh kích hoạt các thuật toán phát hiện bất thường dựa trên mật độ request.
Tối Ưu Bài Toán Crawl Giá Thương Mại Điện Tử Trong Thực Tế
Crawl dữ liệu giá trên sàn TMĐT phức tạp hơn nhiều so với việc trích xuất văn bản đơn thuần trên các trang tin tức. Dưới đây là những kỹ thuật nâng cao giúp hệ thống của bạn hoạt động bền bỉ 24/7.
1. Kết hợp Rotating Proxy với Rotating User-Agent
Một sai lầm phổ biến khi triển khai proxy scrapy python là chỉ xoay IP mà giữ nguyên chuỗi User-Agent. Khi hàng nghìn request đến từ các IP toàn cầu nhưng có chung một thông số chi tiết về trình duyệt, hệ thống bảo mật của sàn TMĐT sẽ dễ dàng nhận diện và gắn cờ tài khoản.
Do đó, bạn nên tích hợp các thư viện xoay User-Agent tự động (như scrapy-user-agents) để đảm bảo mỗi IP đi kèm với một danh tính trình duyệt (Browser Fingerprint) hợp lệ và đa dạng từ Chrome, Firefox, Safari cho đến các thiết bị di động.
2. Lựa chọn đúng loại Proxy phù hợp
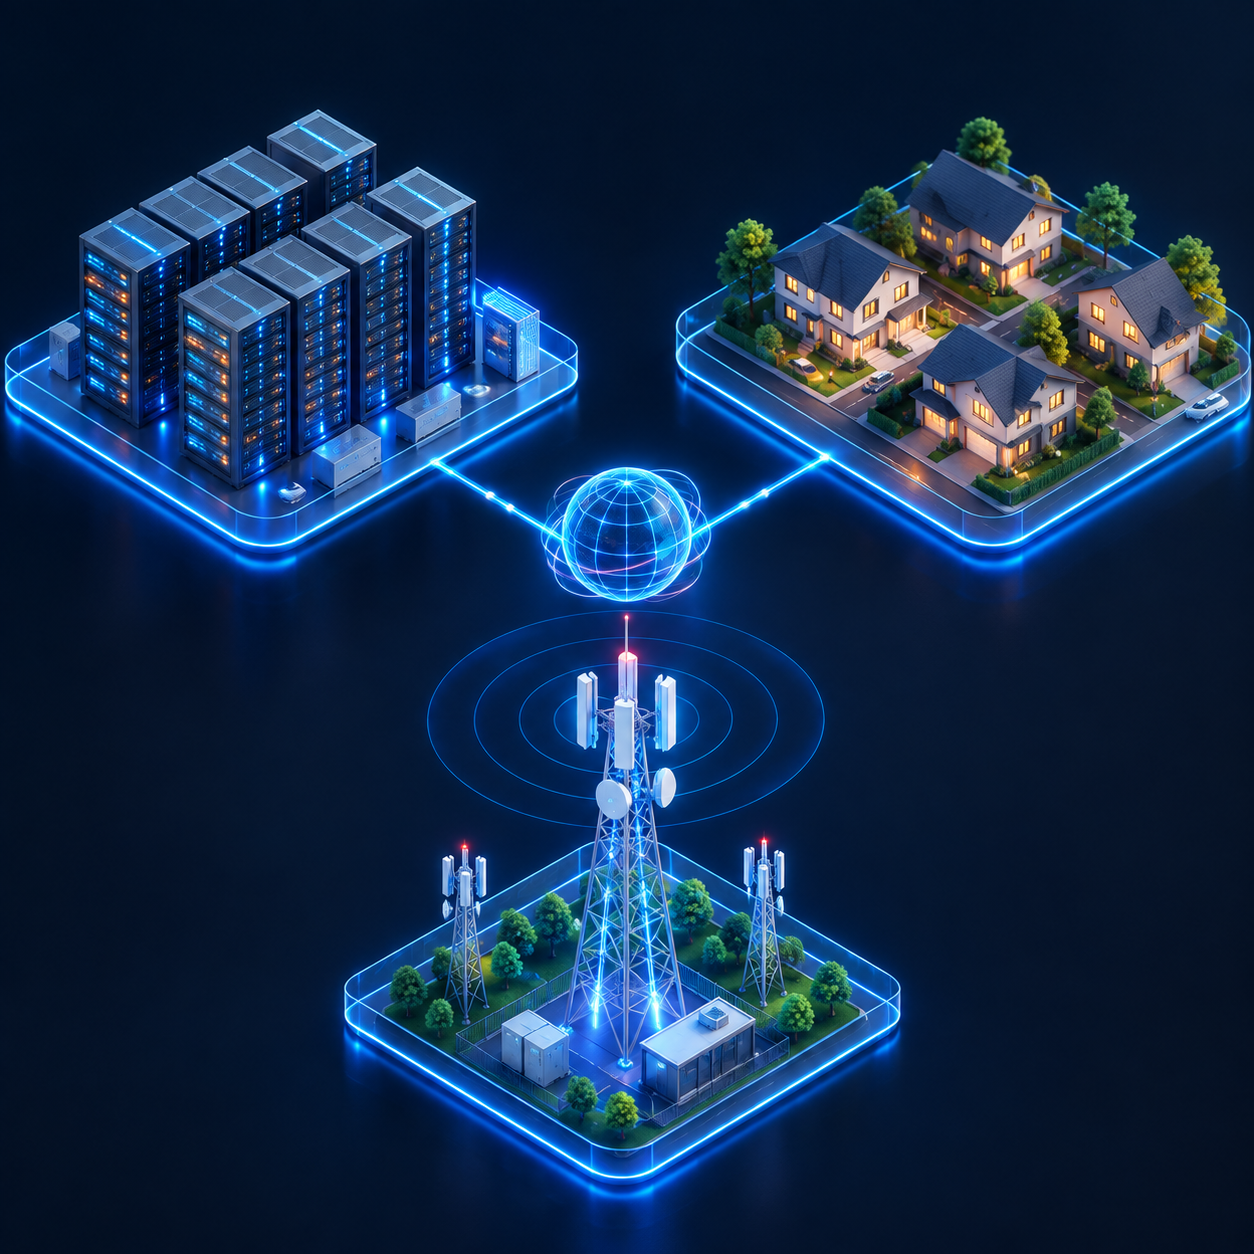 So sánh 3 loại proxy chính: Trung tâm dữ liệu, Dân sự và Di động để lựa chọn giải pháp tối ưu cho việc crawl giá đối thủ.
Không phải tất cả proxy đều có giá trị như nhau trong bài toán crawl gia thương mại điện tử:
- Datacenter Proxies (Proxy trung tâm dữ liệu): Tốc độ rất nhanh và chi phí rẻ, nhưng dải IP thuộc sở hữu của các nhà cung cấp cloud (AWS, DigitalOcean...). Các sàn TMĐT lớn dễ dàng phát hiện và block hàng loạt dải IP này.
- Residential Proxies (Proxy dân sự): Địa chỉ IP thực được cấp bởi các nhà mạng ISP cho hộ gia đình. Đây là loại proxy hiệu quả nhất để crawl giá vì lượng truy cập hoàn toàn giống người dùng thật, tỉ lệ bị block cực thấp.
- Mobile Proxies (Proxy 3G/4G/5G): Sử dụng kết nối mạng di động, có độ tin cậy cao nhất nhưng chi phí đắt đỏ nhất. Thường chỉ dùng làm giải pháp dự phòng khi đối mặt với các trang có hệ thống anti-bot nghiêm ngặt nhất.
3. Xử lý dữ liệu động (JavaScript Rendering) và AJAX Calls
Nhiều trang thương mại điện tử hiện đại ẩn thông tin giá đằng sau các truy vấn API AJAX hoặc dựng giao diện bằng React/Vue/Angular. Việc gửi request HTML đơn thuần sẽ không lấy được giá sản phẩm.
Cách tiếp cận tối ưu là sử dụng công cụ kiểm tra của trình duyệt (F12 Network Tab) để tìm ra endpoint API trực tiếp trả về dữ liệu giá JSON. Khi đã tìm được endpoint này, bạn chỉ cần dùng Scrapy gửi request kèm scrapy proxy middleware trực tiếp tới API đó. Cách này giúp tăng tốc độ crawl lên hàng chục lần so với việc dùng headless browser như Selenium hay Playwright.
Kiểm Soát Lỗi Và Giám Sát Hệ Thống Crawl Tự Động
Một hệ thống thu thập dữ liệu giá đối thủ chuyên nghiệp đòi hỏi cơ chế theo dõi liên tục. Khi triển khai rotating proxy scrapy, bạn cần lưu ý các chỉ số quan trọng sau:
- Tỷ lệ phản hồi thành công (Success Rate): Số lượng response 200 OK trên tổng số request. Tỷ lệ này nên đạt trên 95%. Nếu tỷ lệ này giảm mạnh, có thể danh sách proxy của bạn đã bị lộ hoặc cấu hình middleware chưa chuẩn.
- Thời gian phản hồi trung bình (Latency): Proxy trung gian có thể làm gia tăng độ trễ. Hãy thiết lập giá trị DOWNLOAD_TIMEOUT hợp lý (thường từ 10 - 15 giây) để loại bỏ sớm các proxy phản hồi chậm, tránh làm nghẽn hàng chờ của Scrapy.
- Phát hiện thay đổi cấu trúc HTML: Đôi khi các sàn TMĐT không block IP mà trả về trang báo lỗi tùy chỉnh hoặc đổi cấu trúc DOM. Hãy viết các đoạn mã kiểm tra (validation) dữ liệu đầu ra. Nếu trường giá bị null liên tục, spider cần gửi cảnh báo (alert) ngay lập tức.
Kết Luận
Tự động hóa việc theo dõi giá đối thủ là một bước đi chiến lược giúp doanh nghiệp thương mại điện tử duy trì vị thế cạnh tranh và tối ưu hóa doanh thu. Việc kết hợp sức mạnh thu thập dữ liệu bất đồng bộ của proxy scrapy python cùng giải pháp rotating proxy scrapy giải quyết triệt để bài toán anti-bot, giúp bạn truy cập dữ liệu ổn định và chính xác.
Bằng cách nắm vững việc xây dựng scrapy proxy middleware, lựa chọn đúng loại proxy dân sự và tối ưu hóa chiến lược request, bạn đã sở hữu một hạ tầng dữ liệu mạnh mẽ, sẵn sàng phục vụ cho các bài toán phân tích kinh doanh và định giá tự động trong kỷ nguyên số.
Bài viết liên quan
Sẵn sàng dùng proxy thật, không chỉ đọc hướng dẫn?
Mua proxy Residential, ISP, Datacenter hoặc Mobile — có ngay trong vài phút.
Xem sản phẩm