
Kiến Thức Proxy
Hướng Dẫn Cấu Hình Rotating Proxy Trong Python Để Thu Thập Dữ Liệu Web Không Bị Banned IP

Mục lục
1. Đặt Vấn Đề: Tại Sao Thu Thập Dữ Liệu Web Lại Bị Banned IP?
Trong kỷ nguyên số, việc thu thập dữ liệu web (web scraping) đã trở thành một công cụ thiết yếu đối với các doanh nghiệp, nhà nghiên cứu và lập trình viên. Dữ liệu từ các trang web e-commerce, mạng xã hội hay trang tin tức mang lại giá trị thương mại vô cùng lớn. Tuy nhiên, khi bạn tiến hành thu thập dữ liệu ở quy mô lớn, các hệ thống bảo vệ web sẽ nhanh chóng phát hiện ra các hành vi bất thường.
Các máy chủ web hiện đại được trang bị các cơ chế phòng thủ mạnh mẽ như WAF (Web Application Firewall), Cloudflare, Akamai hay Imperva. Một trong những phương thức kiểm soát phổ biến nhất là Rate Limiting (giới hạn số lượng truy cập). Khi một địa chỉ IP gửi quá nhiều yêu cầu (requests) trong một khoảng thời gian ngắn, hệ thống sẽ tự động xếp loại IP đó vào danh sách nghi vấn và thực hiện các biện pháp xử lý:
- Trả về mã lỗi HTTP 429 (Too Many Requests) hoặc HTTP 403 (Forbidden).
- Hiển thị thử thách CAPTCHA (reCAPTCHA, hCaptcha, Turnstile).
- Khóa toàn bộ kết nối (IP Ban / IP Block) vĩnh viễn hoặc tạm thời.
Để khắc phục triệt để bài toán này, việc áp dụng rotating proxy python (proxy xoay) là giải pháp hàng đầu giúp bạn che giấu danh tính máy chủ, giả lập truy cập từ hàng ngàn người dùng thực và đảm bảo quá trình cào dữ liệu diễn ra liên tục, không bị gián đoạn.
2. Rotating Proxy Là Gì và Cơ Chế Hoạt Động Như Thế Nào?
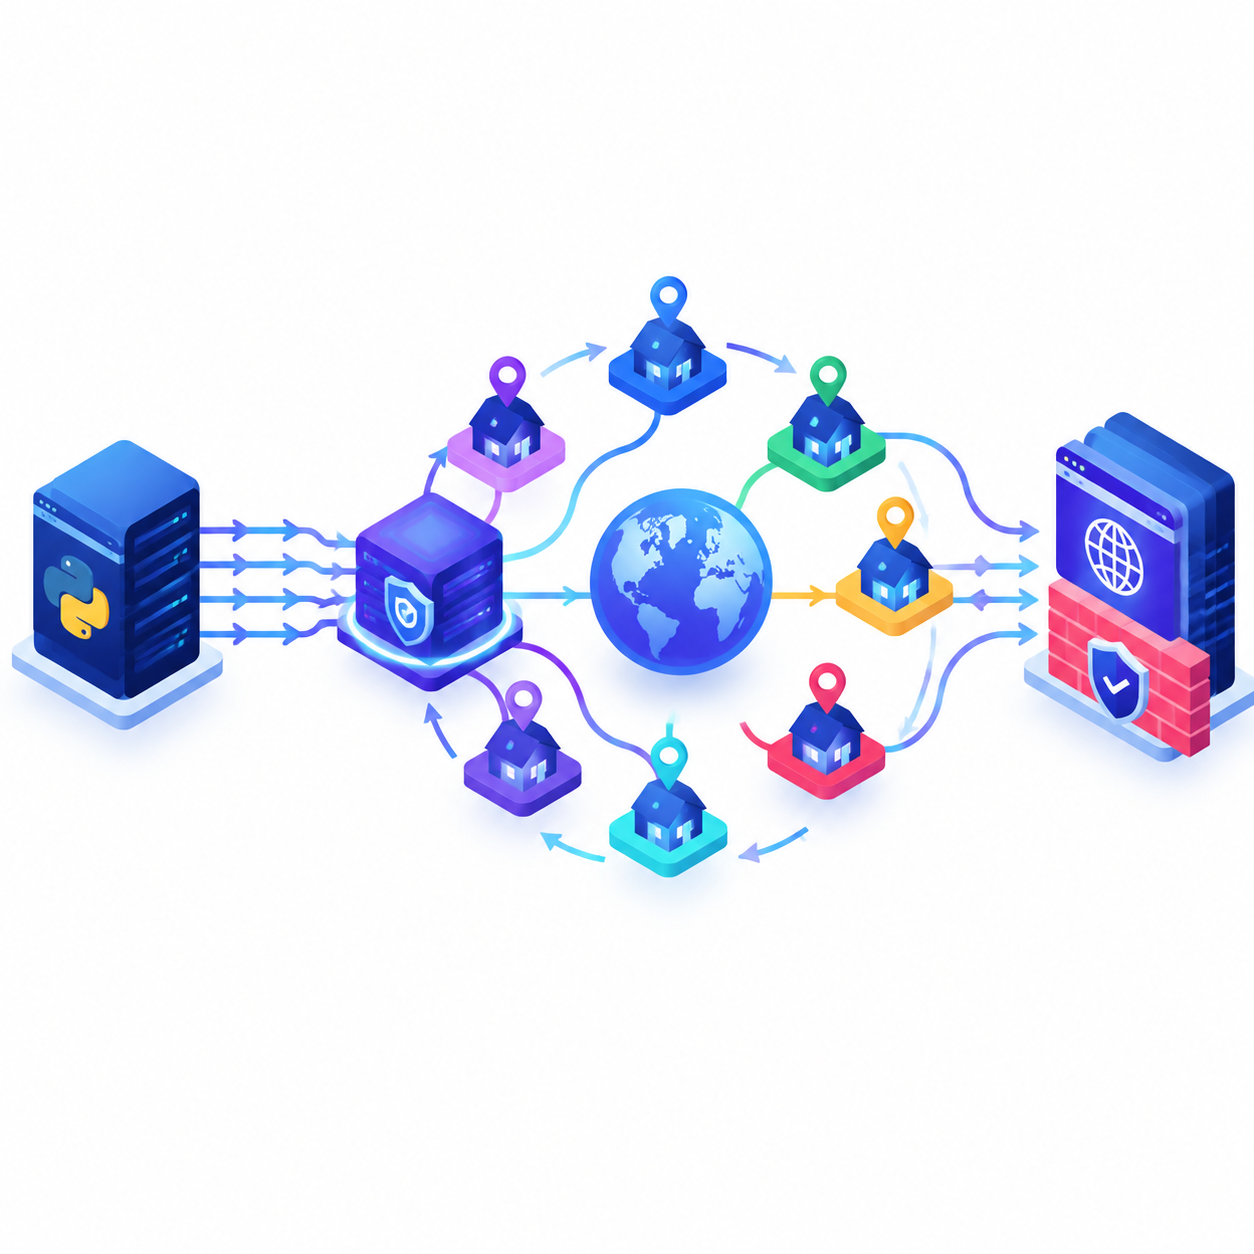 Cơ chế luân chuyển IP tự động của Rotating Proxy giúp che giấu IP gốc và vượt qua hàng rào kiểm soát.
Proxy đóng vai trò là một máy chủ trung gian đứng giữa ứng dụng Python của bạn và trang web mục tiêu. Khi bạn gửi một yêu cầu HTTP thông qua proxy, trang web mục tiêu sẽ chỉ nhìn thấy địa chỉ IP của máy chủ proxy chứ không phải địa chỉ IP thật của bạn.
Phân loại Proxy cơ bản: Datacenter IP và Residential IP
Trước khi đi sâu vào kỹ thuật cấu hình proxy python, bạn cần phân biệt hai loại proxy phổ biến:
- Datacenter Proxy: Là các IP được tạo ra từ các trung tâm dữ liệu (AWS, DigitalOcean, Hetzner...). Ưu điểm là tốc độ rất nhanh, chi phí rẻ. Tuy nhiên, nhược điểm lớn là dễ bị các hệ thống anti-bot phát hiện vì dải IP không thuộc về nhà mạng internet dân dụng (ISP).
- Residential Proxy (Proxy dân dụng): Là địa chỉ IP thực được cấp bởi các nhà mạng (VNPT, Viettel, AT&T, Comcast...) cho hộ gia đình. Đây là loại proxy có độ tin cậy cao nhất, cực kỳ khó bị chặn, nhưng chi phí sẽ cao hơn.
Cơ chế của Rotating Proxy (Proxy Xoay)
Proxy xoay scraping là cơ chế tự động thay đổi địa chỉ IP sau mỗi request HTTP hoặc sau một khoảng thời gian nhất định (vài phút). Thay vì sử dụng một IP duy nhất cho hàng nghìn request, hệ thống sẽ luân chuyển liên tục qua một kho pool chứa hàng triệu IP khác nhau. Nhờ đó, trang web mục tiêu sẽ coi mỗi request của bạn là một người dùng hoàn toàn mới truy cập, gạt bỏ nghi vấn tự động hóa và giúp bạn chống ban ip scraping một cách tối ưu.
3. Hướng Dẫn Cấu Hình Rotating Proxy Với Python Requests
Thư viện requests là công cụ chuẩn mực và phổ biến nhất trong Python để làm việc với các yêu cầu HTTP. Dưới đây là các phương pháp cài đặt python requests proxy từ cơ bản đến chuyên nghiệp.
Phương pháp 1: Cấu hình Proxy đơn lẻ trong Requests
Để hiểu nguyên lý hoạt động, trước tiên bạn cần nắm rõ cách truyền một proxy vào đối tượng request trong Python. Thư viện requests hỗ trợ một từ khóa có tên proxies nhận vào một dictionary chứa thông tin IP và Cổng (Port).
import requests
proxies = {
'http': 'http://10.10.1.10:8080',
'https': 'http://10.10.1.10:1080',
}
response = requests.get('https://httpbin.org/ip', proxies=proxies)
print(response.json())
Nếu proxy của bạn yêu cầu xác thực bằng Username và Password, bạn có thể định dạng chuỗi URL như sau: http://user:password@host:port.
Phương pháp 2: Tự xây dựng cơ chế Proxy Xoay thủ công (Custom Proxy Rotator)
Nếu bạn có một danh sách danh sách các IP tĩnh (Proxy list), bạn có thể chọn ngẫu nhiên một IP cho mỗi request bằng cách sử dụng thư viện random của Python.
import requests
import random
proxy_list = [
'http://user:[email protected]:8080',
'http://user:[email protected]:8080',
'http://user:[email protected]:8080'
]
def get_with_random_proxy(url):
proxy = random.choice(proxy_list)
proxies = {'http': proxy, 'https': proxy}
try:
response = requests.get(url, proxies=proxies, timeout=5)
return response
except requests.exceptions.RequestException as e:
print(f'Proxy {proxy} gặp lỗi: {e}')
return None
Mặc dù giải pháp thủ công này đơn giản, nó tồn tại hạn chế: Bạn phải tự quản lý danh sách IP, tự lọc các IP bị chết (dead proxies) và quy mô danh sách thường bị hạn chế.
Phương pháp 3: Sử dụng Dịch Vụ Rotating Proxy Chuyên Nghiệp (Khuyên Dùng)
Các nhà cung cấp proxy chuyên nghiệp (như Bright Data, Oxylabs, Smartproxy, GeoSurf) cung cấp một điểm truy cập duy nhất (Single Endpoint Gateway). Bạn chỉ cần kết nối đến Endpoint này, và hệ thống phía sau của nhà cung cấp sẽ tự động xoay IP cho bạn trên từng request.
import requests
proxy_endpoint = 'http://username:[email protected]:7000'
proxies = {
'http': proxy_endpoint,
'https': proxy_endpoint
}
for i in range(5):
res = requests.get('https://httpbin.org/ip', proxies=proxies)
print(f'Lần {i+1} - IP hiển thị:', res.json()['origin'])
Với cách làm này, bạn không cần quan tâm đến việc chọn IP hay xử lý IP lỗi, giúp mã nguồn Python của bạn gọn gàng và ổn định hơn rất nhiều.
4. Cấu Hình Rotating Proxy Trong Scrapy Framework
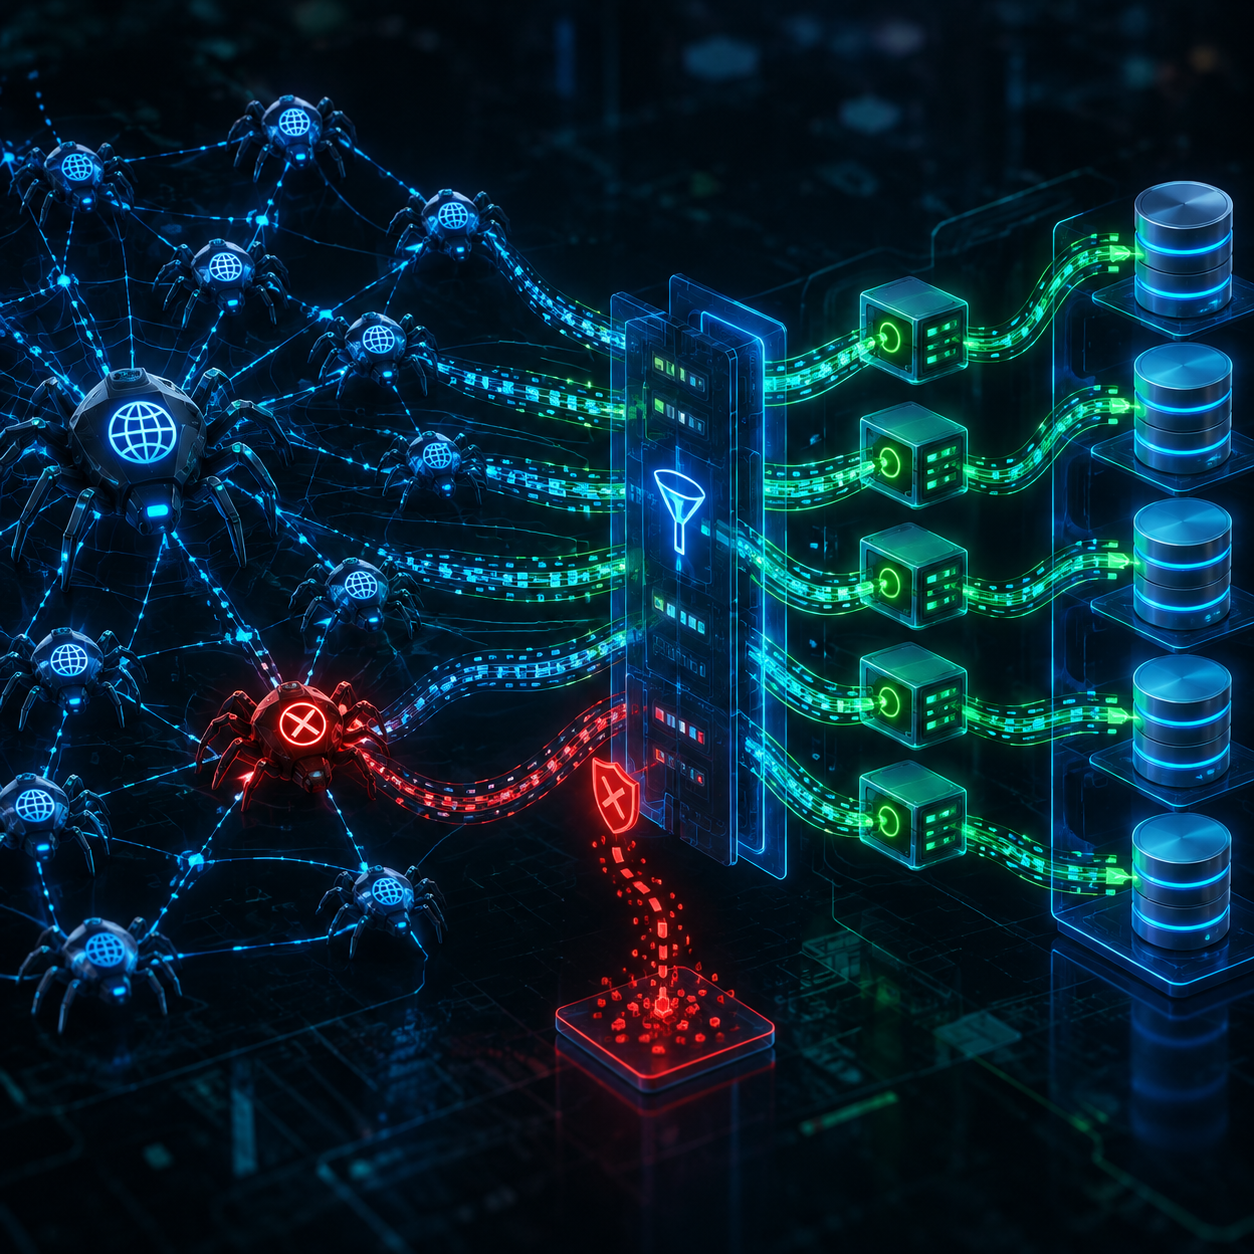 Scrapy Middleware hỗ trợ tự động giám sát trạng thái IP, loại bỏ IP lỗi và chuyển sang proxy mới.
Đối với các dự án thu thập dữ liệu quy mô cực lớn, Scrapy là framework hàng đầu nhờ kiến trúc bất đồng bộ (asynchronous). Để tích hợp rotating proxy python vào Scrapy, chúng ta có thể sử dụng thư viện mở rộng scrapy-rotating-proxies.
Bước 1: Cài đặt thư viện
Bạn cài đặt gói mở rộng bằng lệnh pip:
pip install scrapy-rotating-proxies
Bước 2: Cấu hình tệp settings.py trong dự án Scrapy
Mở tệp settings.py của dự án Scrapy và thêm các dòng cấu hình Middleware sau:
DOWNLOADER_MIDDLEWARES = {
'scrapy_rotating_proxies.middlewares.RotatingProxyMiddleware': 610,
'scrapy_rotating_proxies.middlewares.BanDetectionMiddleware': 620,
}
Tiếp theo, bạn khai báo danh sách IP proxy hoặc đường dẫn tới Endpoint proxy xoay trong settings.py:
ROTATING_PROXY_LIST = [
'http://user:[email protected]:8000',
'http://user:[email protected]:8000',
'http://user:[email protected]:8000',
]
Thư viện scrapy-rotating-proxies sẽ tự động theo dõi tình trạng của từng proxy. Nếu một proxy trả về lỗi (403, 429 hoặc Timeout), thư viện sẽ tự động đánh dấu IP đó là bị ban và chuyển hướng request sang một IP khác hoạt động tốt hơn.
5. Tối Ưu Hiệu Suất Tốc Độ Cao Với Asyncio và Aiohttp
Khi bạn cần gửi hàng ngàn request mỗi phút, việc sử dụng requests (đồng bộ) có thể trở thành nút thắt cổ chai về mặt tốc độ. Kết hợp asyncio, aiohttp cùng với proxy xoay sẽ giúp tăng tốc độ crawler lên gấp nhiều lần.
import asyncio
import aiohttp
proxy = 'http://user:[email protected]:8080'
urls = ['https://httpbin.org/ip' for _ in range(10)]
async def fetch(session, url):
try:
async with session.get(url, proxy=proxy, timeout=10) as response:
json_data = await response.json()
print('IP thu được:', json_data.get('origin'))
except Exception as e:
print('Lỗi kết nối:', e)
async def main():
async with aiohttp.ClientSession() as session:
tasks = [fetch(session, url) for url in urls]
await asyncio.gather(*tasks)
asyncio.run(main())
6. Các Best Practices Giúp Chống Ban IP Khi Scraping Hiệu Quả Nhất
Sử dụng proxy xoay scraping là điều kiện cần, nhưng chưa đủ để đảm bảo chiến dịch cào dữ liệu của bạn thành công 100%. Các hệ thống anti-bot hiện đại phân tích rất nhiều yếu tố khác ngoài địa chỉ IP. Dưới đây là những kinh nghiệm thực chiến giúp bạn nâng cao tỷ lệ thành công:
6.1. Xoay chuyển Header và User-Agent (User-Agent Rotation)
User-Agent là chuỗi thông tin định danh trình duyệt và hệ điều hành gửi tới máy chủ. Nếu hàng ngàn IP khác nhau cùng gửi một chuỗi User-Agent mặc định của Python (ví dụ: Python-requests/2.31.0), hệ thống sẽ ngay lập tức phát hiện đó là bot.
- Sử dụng thư viện fake-useragent để tạo ngẫu nhiên danh sách User-Agent của các trình duyệt phổ biến (Chrome, Firefox, Edge, Safari trên cả Desktop và Mobile).
- Đảm bảo các HTTP Headers quan trọng khác như Accept-Language, Accept-Encoding, Sec-Ch-Ua được khai báo đầy đủ và logic.
6.2. Kiểm soát Tốc độ Yêu cầu (Request Delays & Rate Control)
Gửi request liên tục không có độ trễ (delay) sẽ khiến máy chủ mục tiêu bị quá tải và dễ bị phát hiện. Hãy đưa vào các khoảng nghỉ ngẫu nhiên giữa các request (ví dụ: nghỉ từ 1 đến 3 giây) bằng cách sử dụng time.sleep(random.uniform(1, 3)) trong Python.
6.3. Xử lý Cookies và Session
Nhiều trang web theo dõi hành vi người dùng thông qua Cookie. Khi sử dụng proxy xoay, bạn nên xóa cookie hoặc khởi tạo Session mới đối với các request dùng IP mới để tránh việc hệ thống liên kết các IP khác nhau về cùng một phiên làm việc độc hại.
6.4. Xử lý Trình duyệt Ẩn danh với Selenium hoặc Playwright
Đối với các trang web hiển thị nội dung động bằng JavaScript (SPA, React, Vue), việc gửi request đơn thuần có thể không lấy được dữ liệu. Bạn nên kết hợp Playwright hoặc Selenium ở chế độ Headless, đồng thời tích hợp extension hoặc tham số proxy để vừa giả lập thao tác chuột/cuộn trang, vừa xoay IP an toàn.
7. Lựa Chọn Nhà Cung Cấp Rotating Proxy Nào Tốt Nhất?
Để chọn được dịch vụ cấu hình proxy python phù hợp, bạn cần xem xét các tiêu chí: kích thước pool IP, tỷ lệ thành công của request, tốc độ phản hồi và hỗ trợ vị trí địa lý (Geo-targeting).
- Bright Data (Luminati): Nhà cung cấp có quy mô lớn nhất thế giới với hơn 72 triệu IP dân dụng. Tính năng phong phú, độ tin cậy tuyệt đối nhưng mức giá khá cao, phù hợp với doanh nghiệp lớn.
- Oxylabs: Đối thủ cạnh tranh trực tiếp với Bright Data, nổi tiếng với tốc độ phản hồi cực nhanh và tài liệu API chi tiết cho lập trình viên Python.
- Smartproxy: Sự lựa chọn cân bằng giữa chi phí và chất lượng. Dễ dàng cài đặt, hỗ trợ kỹ thuật tốt, phù hợp cho cả dự án cá nhân lẫn doanh nghiệp vừa và nhỏ.
- IPRoyal: Cung cấp các gói proxy dân dụng không giới hạn thời gian sử dụng (non-expiring traffic), mức giá cạnh tranh và rất thân thiện với người mới bắt đầu.
8. Kết Luận
Việc làm chủ kỹ thuật rotating proxy python là yếu tố quyết định sự thành bại của bất kỳ dự án thu thập dữ liệu web quy mô lớn nào. Bằng cách kết hợp linh hoạt giữa cơ chế xoay IP dân dụng, thay đổi User-Agent thông minh và kiểm soát tần suất request hợp lý, bạn sẽ xây dựng được một hệ thống cào dữ liệu mạnh mẽ, hoạt động bền bỉ mà không lo lo ngại rào cản chống ban ip scraping.
Hãy bắt đầu áp dụng ngay các mẫu mã nguồn trong bài viết này vào dự án của bạn để cảm nhận sự khác biệt về tốc độ cũng như tỷ lệ lấy dữ liệu thành công!
Bài viết liên quan
Sẵn sàng dùng proxy thật, không chỉ đọc hướng dẫn?
Mua proxy Residential, ISP, Datacenter hoặc Mobile — có ngay trong vài phút.
Xem sản phẩm