
Hướng Dẫn Sử Dụng
Hướng dẫn cấu hình Proxy Pool tự động xoay vòng và Failover trong Puppeteer bằng puppeteer-cluster

Mục lục
Tầm quan trọng của Proxy Pool và cơ chế Failover trong Web Scraping
Khi triển khai các hệ thống thu thập dữ liệu quy mô lớn bằng Puppeteer, việc phụ thuộc vào một địa chỉ mạng duy nhất thường dẫn đến tình trạng gián đoạn kết nối hoặc bị giới hạn lưu lượng truy cập từ máy chủ mục tiêu. Để duy trì tính liên tục và ổn định của luồng công việc, giải pháp thiết yếu là tích hợp một hạ tầng proxy pool puppeteer chuyên dụng.
Hạ tầng này không chỉ luân phiên thay đổi địa chỉ kết nối cho từng tác vụ mà còn cần một cơ chế tự phục hồi, hay còn gọi là proxy failover web scraping. Khi một địa chỉ trung gian gặp sự cố, phản hồi chậm hoặc ngừng hoạt động hoàn toàn, hệ thống phải tự động nhận biết, loại bỏ tác nhân lỗi và tái thử nghiệm yêu cầu bằng một địa chỉ khác nhằm bảo đảm tính toàn vẹn của dữ liệu thu thập.
Tổng quan về thư viện puppeteer-cluster
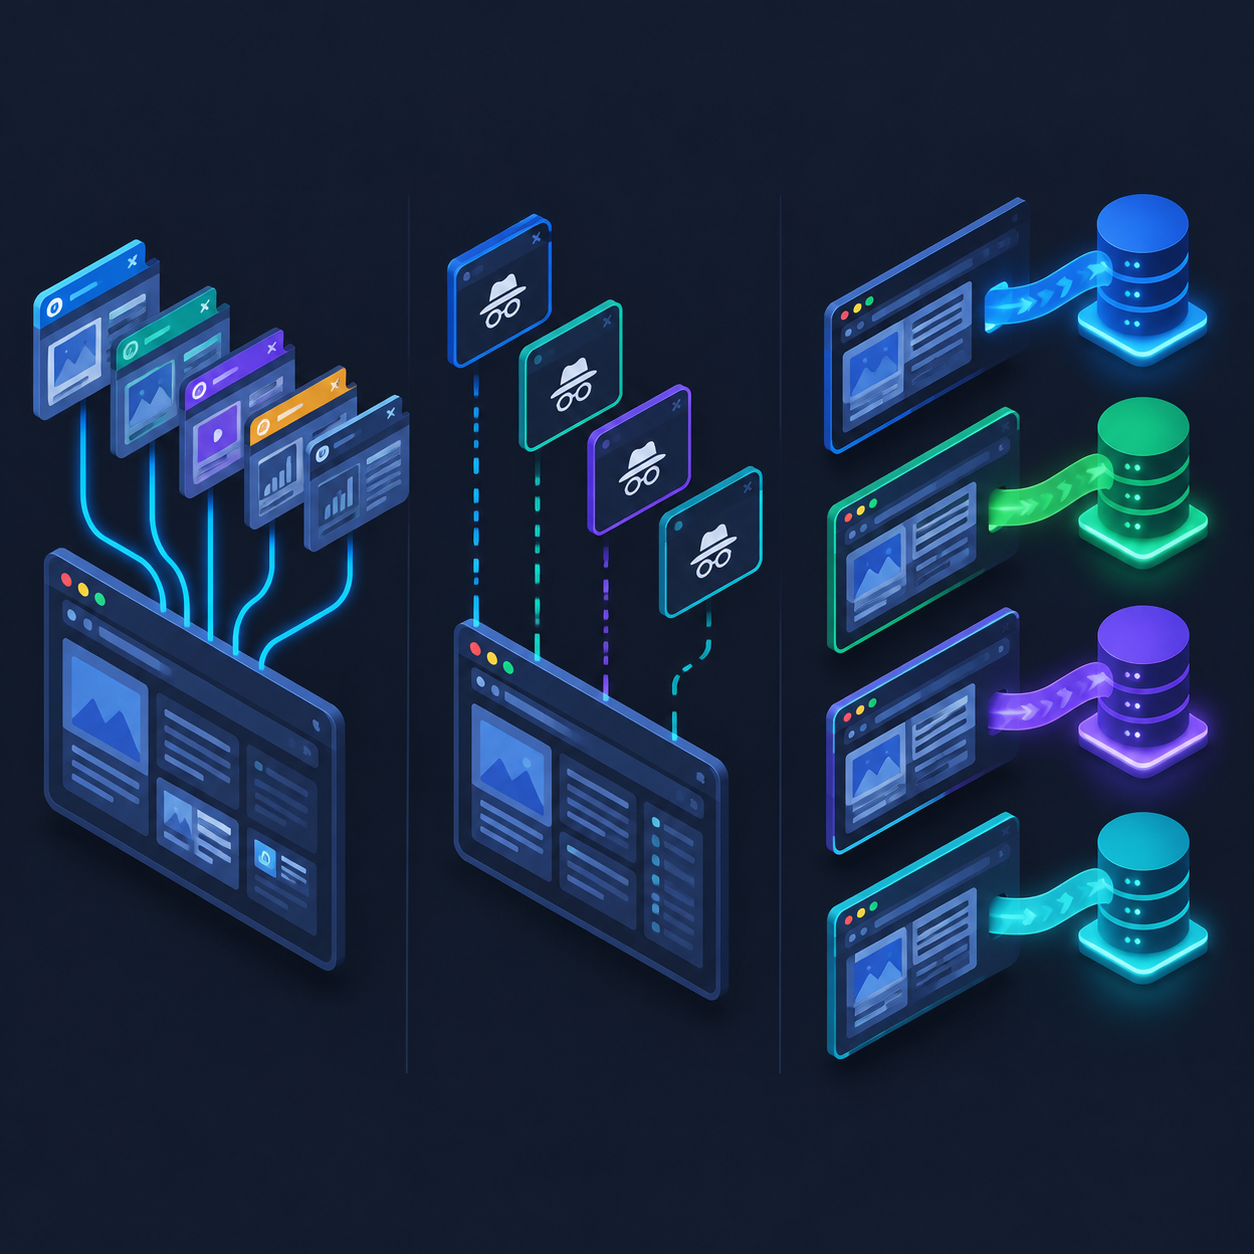 Mô hình Cluster.CONCURRENCY_BROWSER cho phép gán thông số mạng riêng biệt cho từng tiến trình Chromium độc lập.
Puppeteer là một công cụ mạnh mẽ để điều khiển trình duyệt không giao diện, nhưng việc quản lý vòng đời của nhiều tiến trình cùng lúc tiêu tốn rất nhiều tài nguyên phần cứng. Thư viện puppeteer-cluster ra đời nhằm giải quyết bài toán điều phối, cho phép phân bổ công việc đồng thời thông qua các mô hình quản lý phiên làm việc linh hoạt.
Thư viện này cung cấp các chế độ xử lý chính bao gồm:
- Cluster.CONCURRENCY_PAGE: Sử dụng chung một tiến trình trình duyệt và phân nhánh qua các tab. Chế độ này tiết kiệm tài nguyên nhưng không cho phép cấu hình tham số mạng riêng biệt ở cấp độ tiến trình.
- Cluster.CONCURRENCY_CONTEXT: Tận dụng ngữ cảnh ẩn danh trong cùng trình duyệt. Phương pháp này hỗ trợ cô lập cookie và phiên làm việc nhưng vẫn tồn tại giới hạn về tham số khởi động mạng.
- Cluster.CONCURRENCY_BROWSER: Khởi tạo một tiến trình trình duyệt độc lập cho mỗi tác vụ. Đây là mô hình tối ưu nhất để tích hợp puppeteer-cluster proxy vì cho phép áp dụng tham số máy chủ ủy thác riêng biệt ngay từ giai đoạn mở trình duyệt.
Thiết kế kiến trúc Proxy Pool cho puppeteer-cluster
Để xây dựng hệ thống cấu hình proxy xoay vòng puppeteer có khả năng dự phòng lỗi, cấu trúc chương trình cần được phân tách thành hai thành phần chính: Lớp quản lý tài nguyên ủy thác (Proxy Pool Manager) và Lớp điều phối tác vụ (Cluster Runner).
1. Thiết kế bộ quản lý Proxy Pool linh hoạt
Bộ quản lý danh sách địa chỉ cần nắm giữ trạng thái hoạt động của từng điểm kết nối, hỗ trợ lấy luân phiên theo thuật toán vòng tròn và ghi nhận các sự cố mạng để tạm thời cách ly các địa chỉ không phản hồi.
Các thuộc tính quan trọng của một lớp Proxy Manager chuyên nghiệp bao gồm danh sách địa chỉ khả dụng, hàng đợi xoay vòng, danh sách đen tạm thời và bộ đếm số lần thất bại liên tiếp.
2. Lựa chọn chế độ thực thi phù hợp trong puppeteer-cluster
Do cờ tham số mạng của Chromium thường yêu cầu can thiệp từ thời điểm khởi động tiến trình, việc sử dụng chế độ chạy trình duyệt độc lập là yêu cầu bắt buộc để thay đổi địa chỉ kết nối cho từng phiên riêng biệt mà không làm ảnh hưởng đến các tác vụ song song khác.
Hướng dẫn triển khai chi tiết từng bước
Dưới đây là phương pháp lập trình chi tiết để xây dựng giải pháp phân phối yêu cầu và chuyển đổi dự phòng toàn diện.
Bước 1: Cài đặt các gói phụ thuộc
Hệ thống yêu cầu cài đặt môi trường thực thi và các thư viện điều khiển tự động hóa:
Cần thực hiện cài đặt các thư viện puppeteer và puppeteer-cluster thông qua trình quản lý gói của hệ thống để bắt đầu thiết lập mã nguồn.
Bước 2: Xây dựng lớp điều phối Proxy và xử lý lỗi
Lớp này chịu trách nhiệm cấp phát máy chủ ủy thác cho mỗi tác vụ và tiếp nhận phản hồi về tình trạng vận hành của kết nối:
- Thuật toán lấy xoay vòng: Lấy phần tử đầu danh sách, sử dụng cho tác vụ và đẩy về cuối danh sách nếu kết nối ổn định.
- Ghi nhận lỗi (Mark Failed): Khi tác vụ gặp sự cố về thời gian chờ hoặc mất kết nối, điểm truy cập đó sẽ được chuyển sang hàng đợi kiểm tra hoặc tạm thời loại bỏ khỏi vòng quay.
- Phục hồi định kỳ: Cung cấp cơ chế tự động đưa các địa chỉ đã hồi phục trở lại nhóm hoạt động sau một khoảng thời gian chờ nhất định.
Bước 3: Tích hợp Proxy vào quy trình khởi tạo Cluster
Khi khởi tạo đối tượng Cluster, cần can thiệp vào tham số khởi động trình duyệt để gán địa chỉ ủy thác tương ứng. Mỗi khi một tác vụ mới được điều phối, hệ thống sẽ yêu cầu một cấu hình kết nối mới từ Proxy Manager.
Điều này bảo đảm rằng mọi tiến trình độc lập được tạo ra đều hoạt động trên một tuyến truyền tải mạng riêng biệt, phân tán rủi ro và tăng cường tính ổn định chung của toàn bộ luồng dữ liệu.
Bước 4: Thiết lập cơ chế Failover tự động
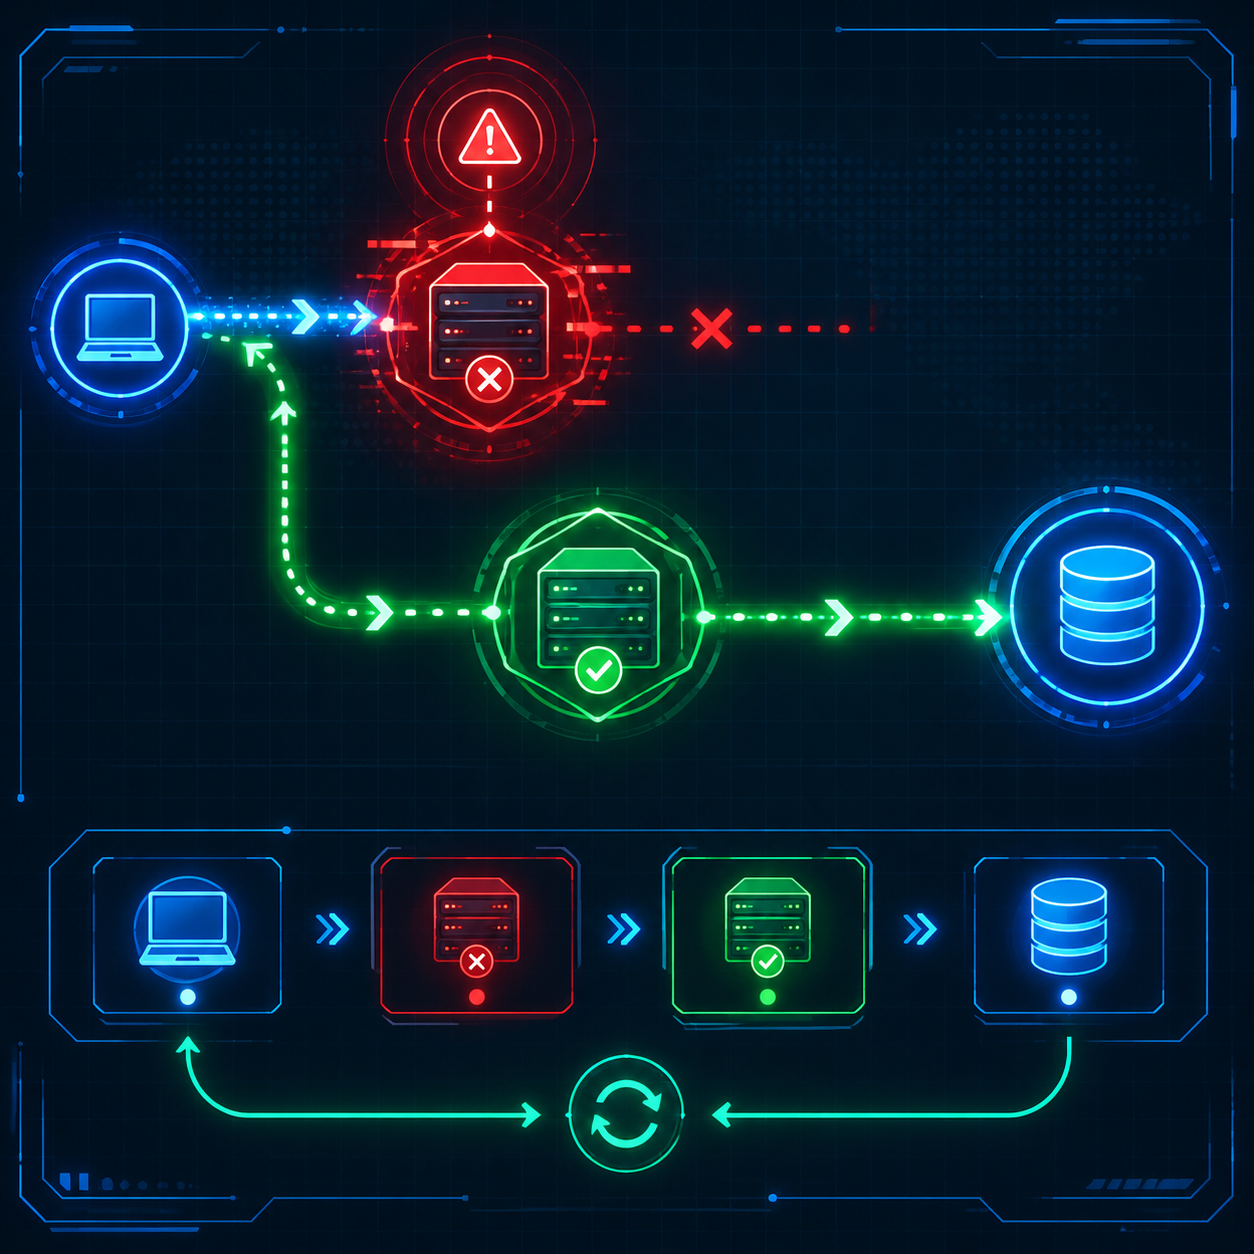 Cơ chế Failover tự động nhận diện điểm truy cập lỗi và đưa tác vụ trở lại hàng đợi với proxy mới.
Cơ chế chuyển đổi dự phòng được kích hoạt khi khối lệnh thực thi của tác vụ phát sinh ngoại lệ liên quan đến hạ tầng mạng. Trình tự xử lý chuẩn bao gồm:
- Bắt lỗi trong khối thực thi chính bằng cấu trúc kiểm soát ngoại lệ.
- Thông báo cho bộ quản lý proxy rằng địa chỉ hiện tại đã phát sinh sự cố.
- Ủy thác lại công việc vào hàng đợi của cluster để thử lại với một địa chỉ khác.
- Xác lập ngưỡng thử lại tối đa cho mỗi tác vụ để tránh tình trạng lặp vô tận khi toàn bộ tài nguyên mạng gặp sự cố.
Xử lý xác thực Proxy trong môi trường Cluster
Các giải pháp cung cấp dịch vụ ủy thác chuyên nghiệp thường yêu cầu cơ chế xác thực danh tính bằng tên người dùng và mật khẩu. Đối với trường hợp này, việc chỉ cung cấp địa chỉ IP và cổng dịch vụ qua tham số dòng lệnh là chưa đủ.
Trong hàm xử lý công việc của từng tác vụ, cần gọi phương thức xác thực của trang để nạp thông tin định danh tương ứng ngay sau khi trang mới được mở. Điều này đảm bảo phiên truy cập được cấp quyền đầy đủ trước khi gửi yêu cầu tới máy chủ đích.
Các lưu ý quan trọng để duy trì hệ thống ổn định
Việc vận hành hệ thống thu thập thông tin quy mô lớn liên tục đòi hỏi các tiêu chuẩn kiểm soát kỹ thuật nghiêm ngặt:
- Quản lý tài nguyên phần cứng: Chế độ khởi chạy nhiều trình duyệt tiêu thụ đáng kể bộ nhớ và năng lượng xử lý. Cần giám sát chặt chẽ năng lực máy chủ để thiết lập số lượng luồng thực thi song song phù hợp, tránh hiện tượng nghẽn tài nguyên.
- Thời gian chờ hợp lý: Thiết lập ngưỡng thời gian chờ kết nối và tải tài nguyên chặt chẽ. Nếu một điểm ủy thác phản hồi quá chậm, hệ thống cần chủ động ngắt kết nối để nhường quyền xử lý cho địa chỉ khác khả dĩ hơn.
- Kiểm soát chất lượng danh sách kết nối: Định kỳ sàng lọc các địa chỉ không phản hồi khỏi danh mục lưu trữ để tối ưu hóa thời gian thực thi của hàng đợi tác vụ.
Kết luận
Việc kết hợp giải pháp puppeteer-cluster proxy cùng cấu trúc quản lý xoay vòng và dự phòng lỗi giúp xây dựng hệ thống thu thập dữ liệu chuyên nghiệp, bền bỉ và có khả năng mở rộng cao. Bằng cách điều phối tài nguyên hợp lý và chủ động xử lý các rủi ro về kết nối mạng, các tác vụ tự động hóa sẽ vận hành liền mạch, đáp ứng tốt yêu cầu xử lý dữ liệu phức tạp trong môi trường thực tế.
Bài viết liên quan
Sẵn sàng dùng proxy thật, không chỉ đọc hướng dẫn?
Mua proxy Residential, ISP, Datacenter hoặc Mobile — có ngay trong vài phút.
Xem sản phẩm