
Kiến Thức Proxy
Hướng Dẫn Cấu Hình Proxy Datacenter Để Web Scraping Tốc Độ Cao Cho Doanh Nghiệp

Mục lục
Giới thiệu về Proxy Datacenter trong Web Scraping quy mô lớn
Trong thời đại số hóa, dữ liệu được coi là tài nguyên vô giá giúp doanh nghiệp đưa ra các quyết định chiến lược kinh doanh sáng suốt. Tuy nhiên, việc cào dữ liệu ở quy mô lớn thường gặp phải rào cản từ các cơ chế chống bot nâng cao của website mục tiêu. Để giải quyết thách thức này, giải pháp sử dụng proxy datacenter trở thành lựa chọn hàng đầu nhờ tốc độ xử lý vượt trội và chi phí tối ưu.
Bài viết này sẽ hướng dẫn chi tiết cách cấu hình proxy datacenter nhằm đạt hiệu suất web scraping tốc độ cao, giúp hệ thống proxy crawler dữ liệu của doanh nghiệp vận hành mượt mà và ổn định.
Tại sao nên chọn Proxy Datacenter cho Web Scraping doanh nghiệp?
Proxy datacenter là loại IP được cung cấp bởi các trung tâm dữ liệu độc lập, không phụ thuộc vào nhà mạng internet dân dụng. So với proxy dân dụng (residential proxy), loại proxy này mang lại những lợi thế cạnh tranh rõ rệt:
Tốc độ và băng thông vượt trội: Nhờ hạ tầng mạng tại trung tâm dữ liệu, thời gian phản hồi (latency) cực thấp và độ ổn định cao, hoàn toàn phù hợp cho các dự án web scraping tốc độ cao.
Tối ưu chi phí: Giá thành của IP datacenter rẻ hơn đáng kể so với IP dân dụng khi doanh nghiệp cần thực hiện hàng triệu request mỗi ngày.
Khả năng mở rộng dễ dàng: Doanh nghiệp có thể nhanh chóng mua và quản lý hàng nghìn địa chỉ IP để phục vụ cho các chiến dịch thu thập dữ liệu quy mô lớn.
Hướng dẫn các bước cấu hình Proxy Datacenter đạt hiệu suất tối đa
Để xây dựng một hạ tầng proxy crawler dữ liệu hoạt động hiệu quả, việc thiết lập đúng kỹ thuật là yếu tố quyết định. Dưới đây là các bước chi tiết để cấu hình proxy datacenter bài bản.
1. Lựa chọn giao thức kết nối phù hợp (HTTP/HTTPS vs SOCKS5)
Mỗi giao thức kết nối mang lại hiệu quả khác nhau tùy thuộc vào mục tiêu thu thập dữ liệu:
HTTP/HTTPS Proxy: Phù hợp cho việc cào dữ liệu web thông thường. Giao thức này cho phép dễ dàng can thiệp và tùy biến các HTTP header như User-Agent, Cookie hay Referer.
SOCKS5 Proxy: Lựa chọn tối ưu khi cần hiệu suất cao hơn, hỗ trợ truyền tải dữ liệu linh hoạt và tính bảo mật vượt trội ở tầng giao vận.
2. Thiết lập cơ chế xoay tua IP (IP Rotation)
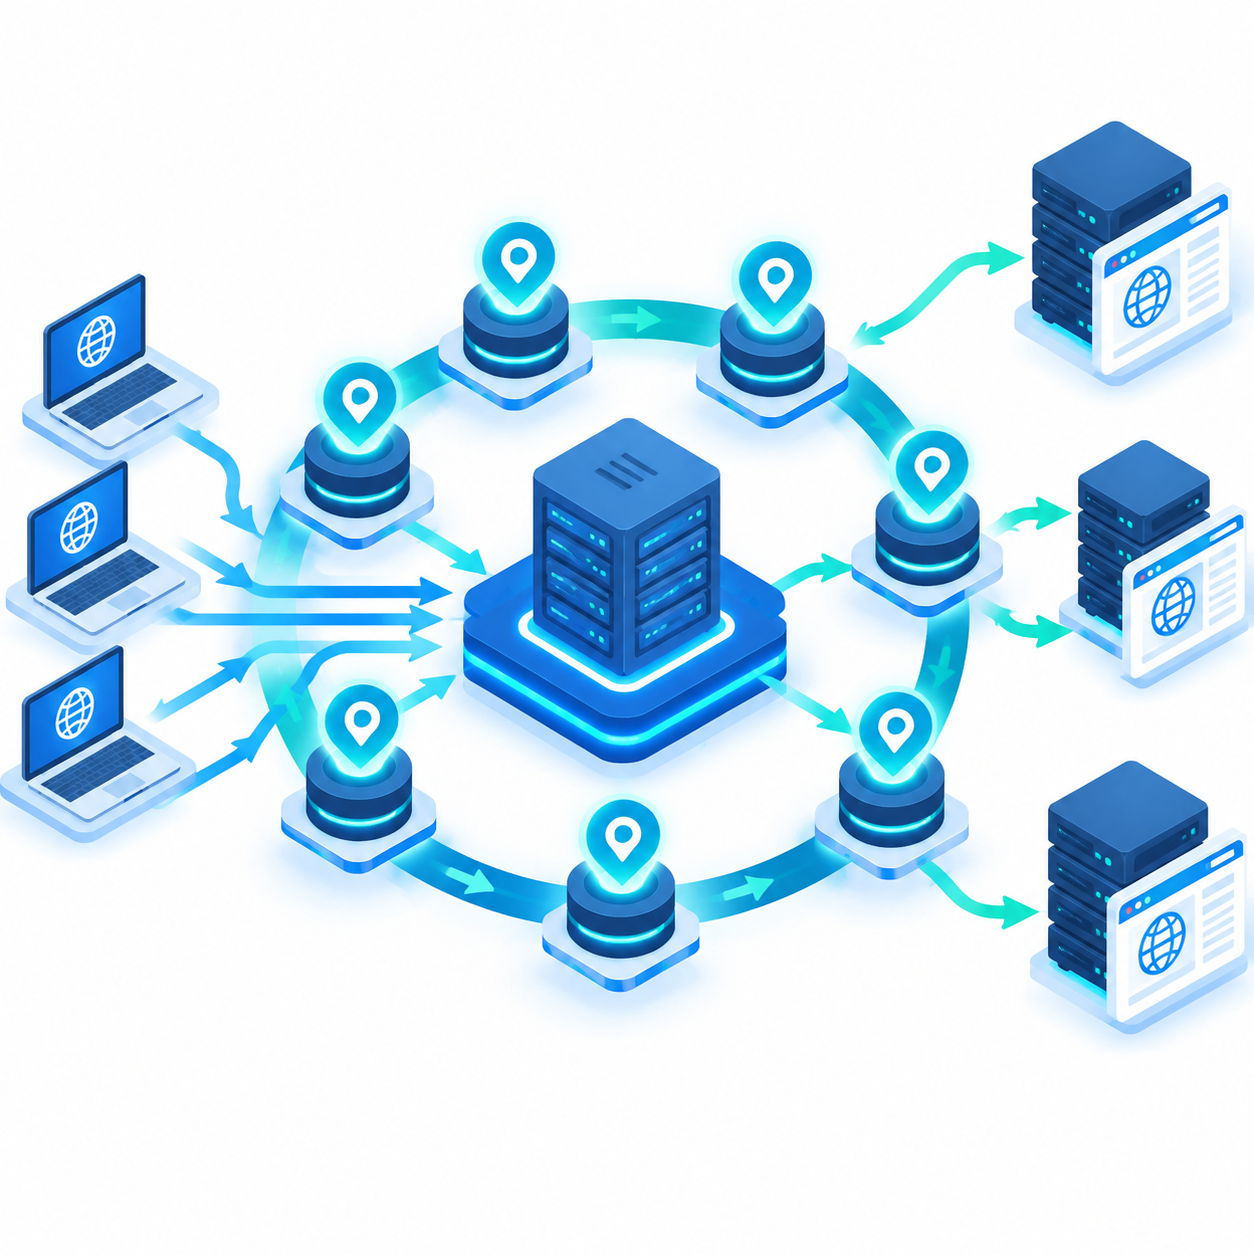 Cơ chế xoay tua IP giúp phân tán lượng request, tránh bị hệ thống đối phương khóa IP khi scraping.
Các trang web hiện đại thường theo dõi số lượng request từ một địa chỉ IP duy nhất. Nếu gửi quá nhiều request trong thời gian ngắn, IP của bạn chắc chắn sẽ bị khóa. Giải pháp là áp dụng kỹ thuật xoay tua IP:
Xoay tua theo Request (Random Rotation): Mỗi request gửi đi sẽ sử dụng một IP ngẫu nhiên trong danh sách proxy. Kỹ thuật này cực kỳ hiệu quả khi scraping các trang web không yêu cầu đăng nhập.
Xoay tua theo Phiên (Session-based Rotation): Giữ nguyên một IP trong một khoảng thời gian nhất định (ví dụ: 5-10 phút) để hoàn thành một quy trình trước khi đổi sang IP mới.
3. Quản lý Request Header và Giả lập trình duyệt
Một địa chỉ proxy datacenter dù nhanh đến đâu cũng dễ bị phát hiện nếu gửi request với thông tin header mặc định của các thư viện cào dữ liệu (như Python Requests hay Axios). Do đó, doanh nghiệp cần:
Tạo danh sách User-Agent phong phú đại diện cho các trình duyệt phổ biến trên cả máy tính và điện thoại.
Thay đổi linh hoạt các header khác như Accept-Language, Accept-Encoding để giống với người dùng thật.
4. Xử lý giới hạn tần suất (Rate Limiting) và Delay hợp lý
Mặc dù mục tiêu là web scraping tốc độ cao, việc gửi request quá dồn dập sẽ làm sập server đối phương hoặc kích hoạt tường lửa bảo mật. Hãy thiết lập khoảng nghỉ ngẫu nhiên từ 0.5 đến 2 giây giữa các request để giảm thiểu nguy cơ bị phát hiện.
5. Xây dựng hệ thống tự động xử lý lỗi và Retries
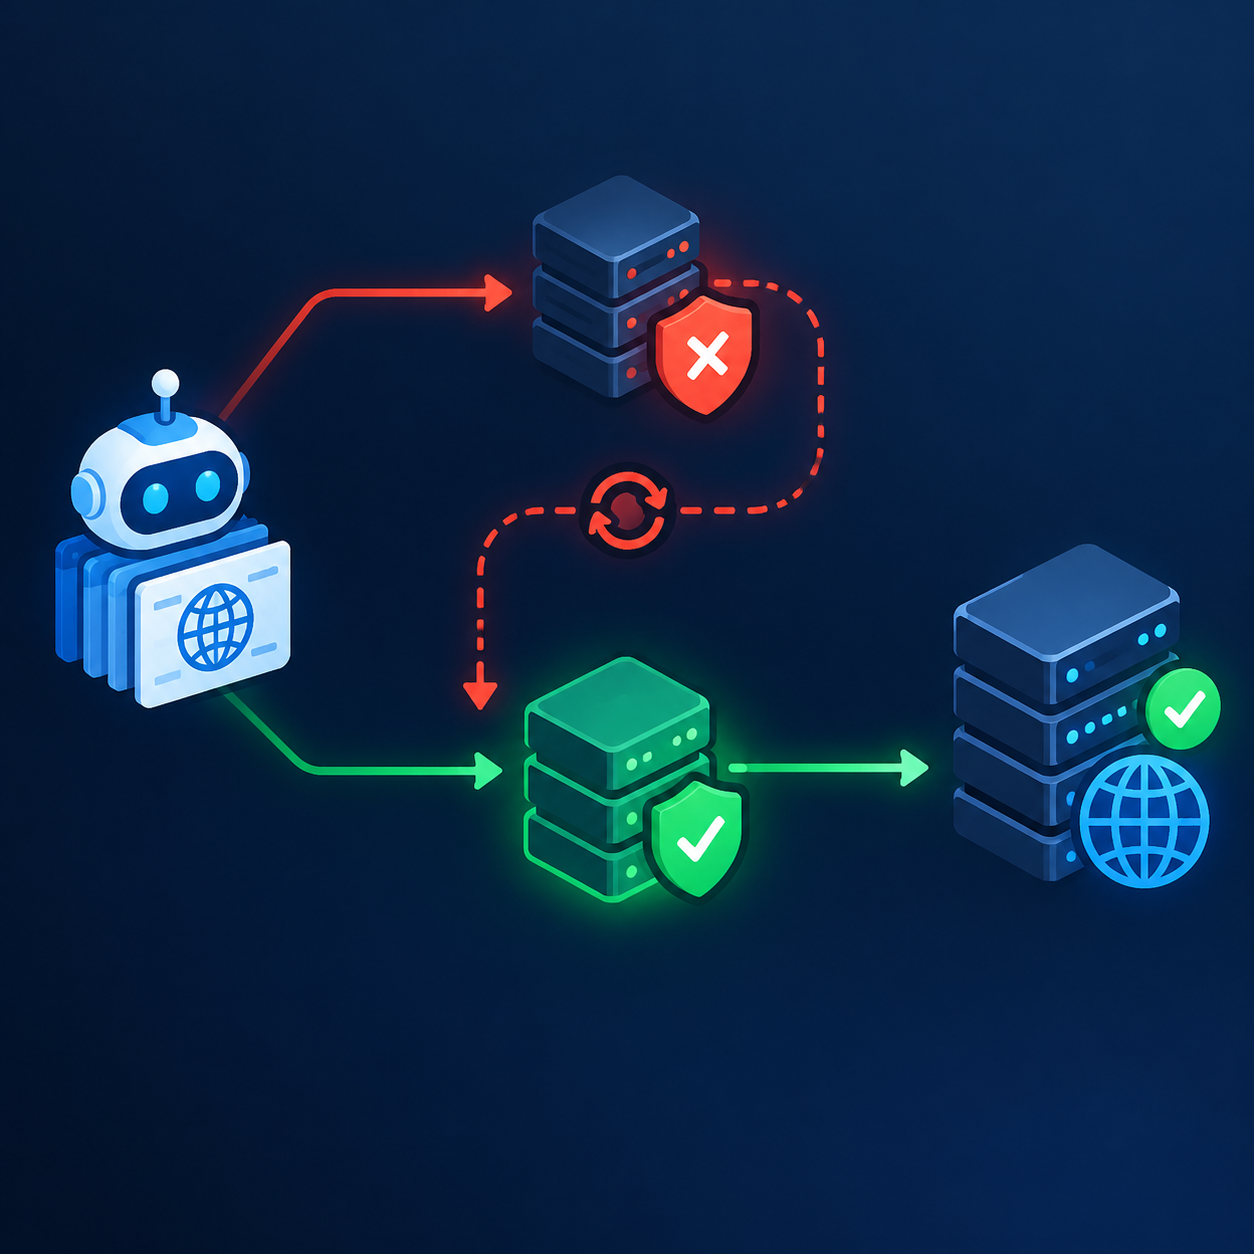 Hệ thống tự động nhận diện lỗi kết nối và chuyển hướng sang địa chỉ IP dự phòng để gửi lại request.
Hệ thống proxy crawler dữ liệu cần có cơ chế tự động ghi nhận các mã lỗi HTTP (như 403 Forbidden, 429 Too Many Requests). Khi gặp các lỗi này, hệ thống nên:
Tự động loại bỏ IP đang bị lỗi khỏi danh sách hoạt động tạm thời.
Thực hiện gửi lại request (retry) bằng một IP proxy datacenter khác trong danh sách dự phòng.
Giải pháp khắc phục hạn chế của Proxy Datacenter
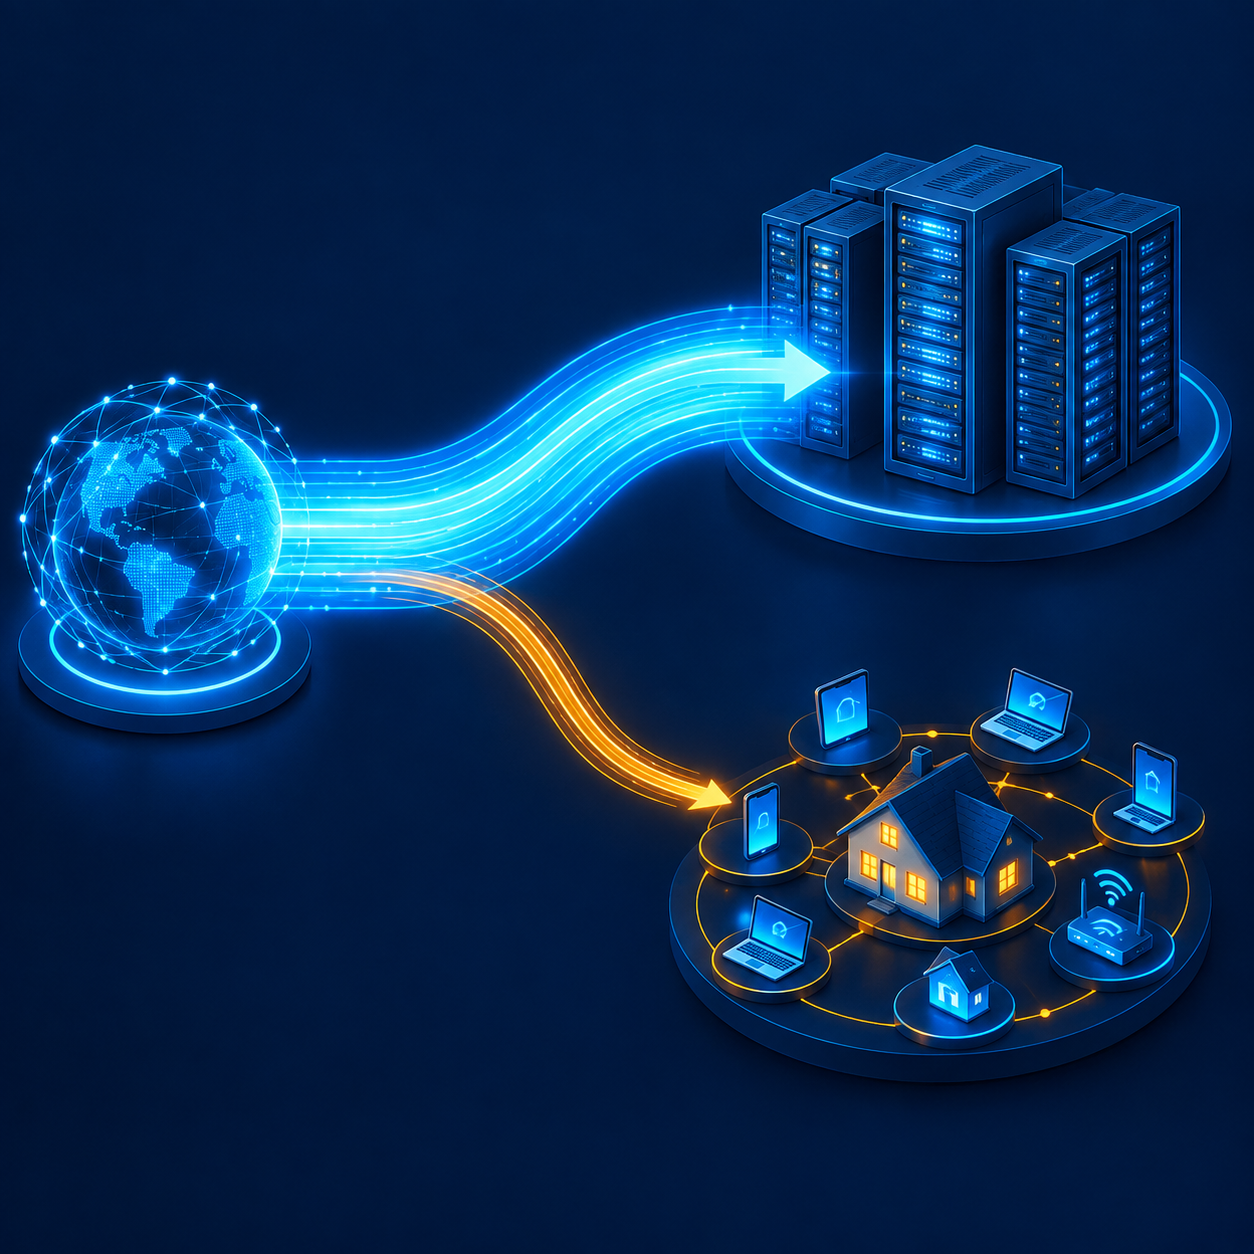 Mô hình kết hợp linh hoạt: dùng proxy datacenter cho phần lớn lượng request và proxy dân dụng cho các mục tiêu khó.
Nhược điểm lớn nhất của IP datacenter là dễ bị nhận diện bởi các hệ thống chống bot nâng cao vì dải IP của trung tâm dữ liệu thường khai báo công khai. Để khắc phục điều này, doanh nghiệp nên áp dụng chiến lược kết hợp linh hoạt:
Sử dụng proxy datacenter cho 80-90% các trang web thông thường hoặc dữ liệu tĩnh để tiết kiệm chi phí và tăng tốc độ tối đa.
Tự động chuyển hướng sang Proxy Dân Dụng (Residential Proxy) chỉ khi gặp phải các trang web có cơ chế bảo mật nghiêm ngặt hoặc yêu cầu xác minh Captcha complex.
Tổng kết
Việc cấu hình proxy datacenter chuẩn kỹ thuật là chìa khóa giúp doanh nghiệp làm chủ công nghệ thu thập dữ liệu quy mô lớn. Với khả năng phản hồi nhanh chóng và tối ưu chi phí, hệ thống proxy crawler dữ liệu ứng dụng proxy datacenter sẽ mang lại hiệu quả vượt trội cho hoạt động web scraping tốc độ cao.
Hãy bắt đầu bằng việc lựa chọn nhà cung cấp proxy uy tín, kết hợp với các giải pháp xoay tua IP linh hoạt và quản lý request thông minh để đảm bảo luồng dữ liệu của doanh nghiệp luôn thông suốt.
Bài viết liên quan
Sẵn sàng dùng proxy thật, không chỉ đọc hướng dẫn?
Mua proxy Residential, ISP, Datacenter hoặc Mobile — có ngay trong vài phút.
Xem sản phẩm