
Знания о прокси
Руководство по настройке Rotating Proxy в Scrapy для мониторинга цен конкурентов на маркетплейсах

Содержание
Постановка проблемы: Почему мониторинг цен конкурентов критически важен для выживания на маркетплейсах?
В условиях бурного роста рынка электронной коммерции ценообразование стало одним из важнейших факторов выживания в конкурентной борьбе. На крупных маркетплейсах, таких как Shopee, Lazada, Tiki или Amazon, гонка цен происходит каждый час или даже каждую минуту. Компании, которые быстрее всех отслеживают изменения цен конкурентов, получают максимальное преимущество при автоматическом изменении собственных цен (динамическом ценообразовании), оптимизации рекламных кампаний и защите маржинальности.
Однако сбор данных о ценах в больших масштабах сталкивается с серьезными техническими препятствиями со стороны систем антибот-защиты. Платформы электронной коммерции применяют множество сложных механизмов, таких как ограничение частоты запросов (rate limiting), блокировка IP-адресов, ввод CAPTCHA или проверка цифрового отпечатка браузера. Если вы используете только один IP-адрес для доступа к тысячам страниц товаров за короткий промежуток времени, ваш IP будет мгновенно заблокирован. Именно поэтому использование proxy scrapy python и техники rotating proxy scrapy стало стандартным профессиональным решением для парсинга цен в электронной коммерции.
Роль ротируемых прокси в сборе данных e-commerce
Прокси-сервер выступает в качестве промежуточного звена между вашим приложением для сбора данных (Scrapy Spider) и целевым веб-сайтом. При использовании прокси реальный IP-адрес сервера-паука скрывается, и целевой сайт фиксирует только IP-адрес прокси-сервера.
Однако при использовании только одного статического прокси (Static Proxy) риск обнаружения и блокировки при отправке множества запросов остается крайне высоким. Технология rotating proxy scrapy (ротация IP-адресов) автоматически меняет исходящий IP-адрес для каждого HTTP-запроса или через определенные интервалы времени. Это дает существенные преимущества:
- Обход ограничений частоты запросов (Rate Limit): Распределение тысяч запросов по сотням различных IP-адресов заставляет систему мониторинга сайта воспринимать скрапинг как естественный трафик от множества независимых пользователей.
- Предотвращение массовой блокировки IP: Если один IP-адрес обнаружен и временно заблокирован (возвращает ошибку HTTP 403 Forbidden или 429 Too Many Requests), система немедленно исключит его и переключится на другой «чистый» IP для продолжения работы без остановки всего процесса.
- Сбор данных с учетом геопозиции (Geo-targeting): Многие маркетплейсы отображают разные цены и стоимость доставки в зависимости от региона покупателя. Ротируемые прокси позволяют выбирать IP конкретных городов или стран для получения наиболее точной информации о ценах.
Обзор архитектуры Scrapy Proxy Middleware
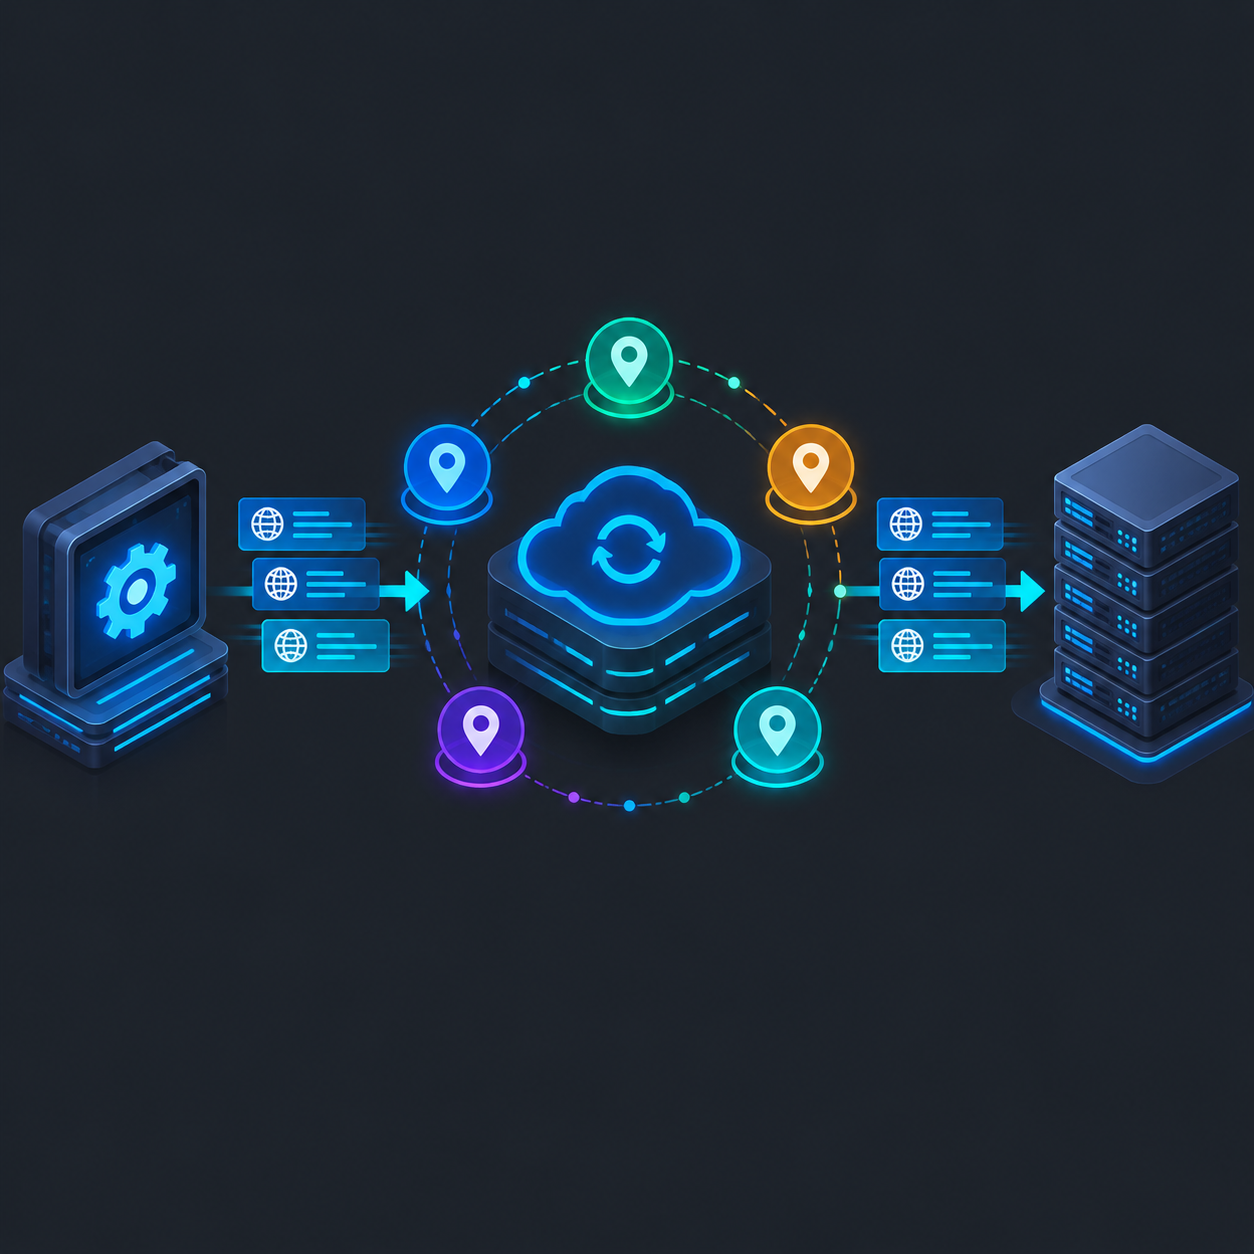 Архитектура Scrapy Middleware перехватывает HTTP-запросы и подставляет новые IP-адреса до отправки на сайт.
Scrapy — это мощный фреймворк на Python, разработанный специально для веб-скрейпинга. Основой управления и ротации IP-адресов в Scrapy является компонент scrapy proxy middleware (Downloader Middleware).
Downloader Middleware находится между процессом скачивания (Downloader Engine) и конвейером обработки запросов/ответов (Request/Response pipeline). Каждый раз, когда Spider генерирует запрос, он проходит через Downloader Middleware перед отправкой в сеть. На этом этапе мы можем изменять заголовки (headers) запроса, назначать прокси-адрес, менять User-Agent или обрабатывать исключения, возвращаемые целевым сервером.
Пошаговое руководство по настройке ротируемых прокси в Scrapy
Шаг 1: Подготовка окружения и проекта Scrapy
Для начала убедитесь, что у вас установлен Python (версии 3.8 или выше) и виртуальное окружение (virtualenv). Установите фреймворк Scrapy и необходимые библиотеки с помощью стандартных команд в терминале.
После создания нового проекта Scrapy вы получите стандартную структуру каталогов, включающую ключевые файлы settings.py, middlewares.py и папку spiders/.
Шаг 2: Выбор способа реализации ротации прокси
В настоящее время существуют два основных метода интеграции rotating proxy scrapy в ваш проект на Python:
- Использование готовой библиотеки (scrapy-rotating-proxies): Подходит для работы с собственным списком прокси (List of IP:Port). Эта библиотека автоматически отслеживает производительность каждого IP, временно отключает неработающие или заблокированные IP и отдает приоритет стабильным адресам.
- Использование сервиса ротации прокси (Proxy Provider Endpoint): Профессиональные прокси-провайдеры (такие как Bright Data, Oxylabs, Smartproxy) предоставляют единый endpoint (например, proxy.example.com:8080). Каждый запрос, отправленный через эту точку входа, автоматически ротируется на новый IP-адрес на стороне сервера провайдера. Этот метод является наиболее простым и эффективным для крупномасштабных проектов.
Шаг 3: Создание пользовательского Scrapy Proxy Middleware
Для максимального контроля над обработкой запросов инженеры по данным предпочитают писать собственный scrapy proxy middleware. Ниже описана основная логика, которую необходимо реализовать в файле middlewares.py:
В методе process_request мы извлекаем адрес прокси из доступного списка или из сервиса ротации, после чего назначаем его напрямую в свойство request.meta['proxy']. Если прокси требует авторизации по логину и паролю, данные учетной записи должны быть закодированы в формате Base64 и переданы в заголовок Proxy-Authorization.
В методе process_response middleware проверяет HTTP-код ответа от маркетплейса. При обнаружении кодов ошибок, указывающих на блокировку (403, 429, 503), или при появлении страницы с CAPTCHA middleware отключает текущий IP, меняет его на новый и возвращает этот запрос обратно в очередь (scheduler) для повторной попытки (retry).
Шаг 4: Настройка конфигурации в settings.py
Файл settings.py служит центральным пунктом управления для всего краулера. Для оптимизации парсинга цен в e-commerce и гладкой интеграции прокси вам следует обновить следующие параметры:
Активируйте Custom Middleware, объявив его в параметре DOWNLOADER_MIDDLEWARES с соответствующим приоритетом (обычно от 300 до 750), чтобы убедиться, что он выполняется до компонентов сжатия данных или обработки cookie.
Отключите управление cookie (COOKIES_ENABLED = False), если только авторизация не является обязательной. Отправка постоянного cookie-файла с разных IP-адресов — один из главных признаков, по которым антибот-системы выявляют подозрительную активность.
Отрегулируйте параметры параллелизма и задержки. При использовании качественной системы rotating proxy scrapy вы можете увеличить значение CONCURRENT_REQUESTS для ускорения сбора данных. Тем не менее рекомендуется установить небольшой случайный интервал DOWNLOAD_DELAY (расширение AutoThrottle), чтобы снизить нагрузку на целевой сервер и избежать срабатывания алгоритмов обнаружения аномалий по плотности запросов.
Практическая оптимизация парсинга цен в e-commerce
Сбор данных о ценах на маркетплейсах намного сложнее простого извлечения текста с новостных сайтов. Ниже приведены продвинутые методы, которые помогут вашей системе работать непрерывно 24/7.
1. Сочетание ротации прокси с ротацией User-Agent
Распространенная ошибка при использовании proxy scrapy python — ротировать только IP, оставляя неизменной строку User-Agent. Когда тысячи запросов поступают с разных IP по всему миру, но с одинаковыми параметрами браузера, система безопасности маркетплейса легко распознает и заблокирует такой трафик.
Поэтому вам следует интегрировать библиотеки автоматической ротации User-Agent (например, scrapy-user-agents), чтобы каждый IP сопровождался валидным и разнообразным цифровым отпечатком браузера (Browser Fingerprint) — от Chrome, Firefox и Safari до мобильных устройств.
2. Выбор правильного типа прокси
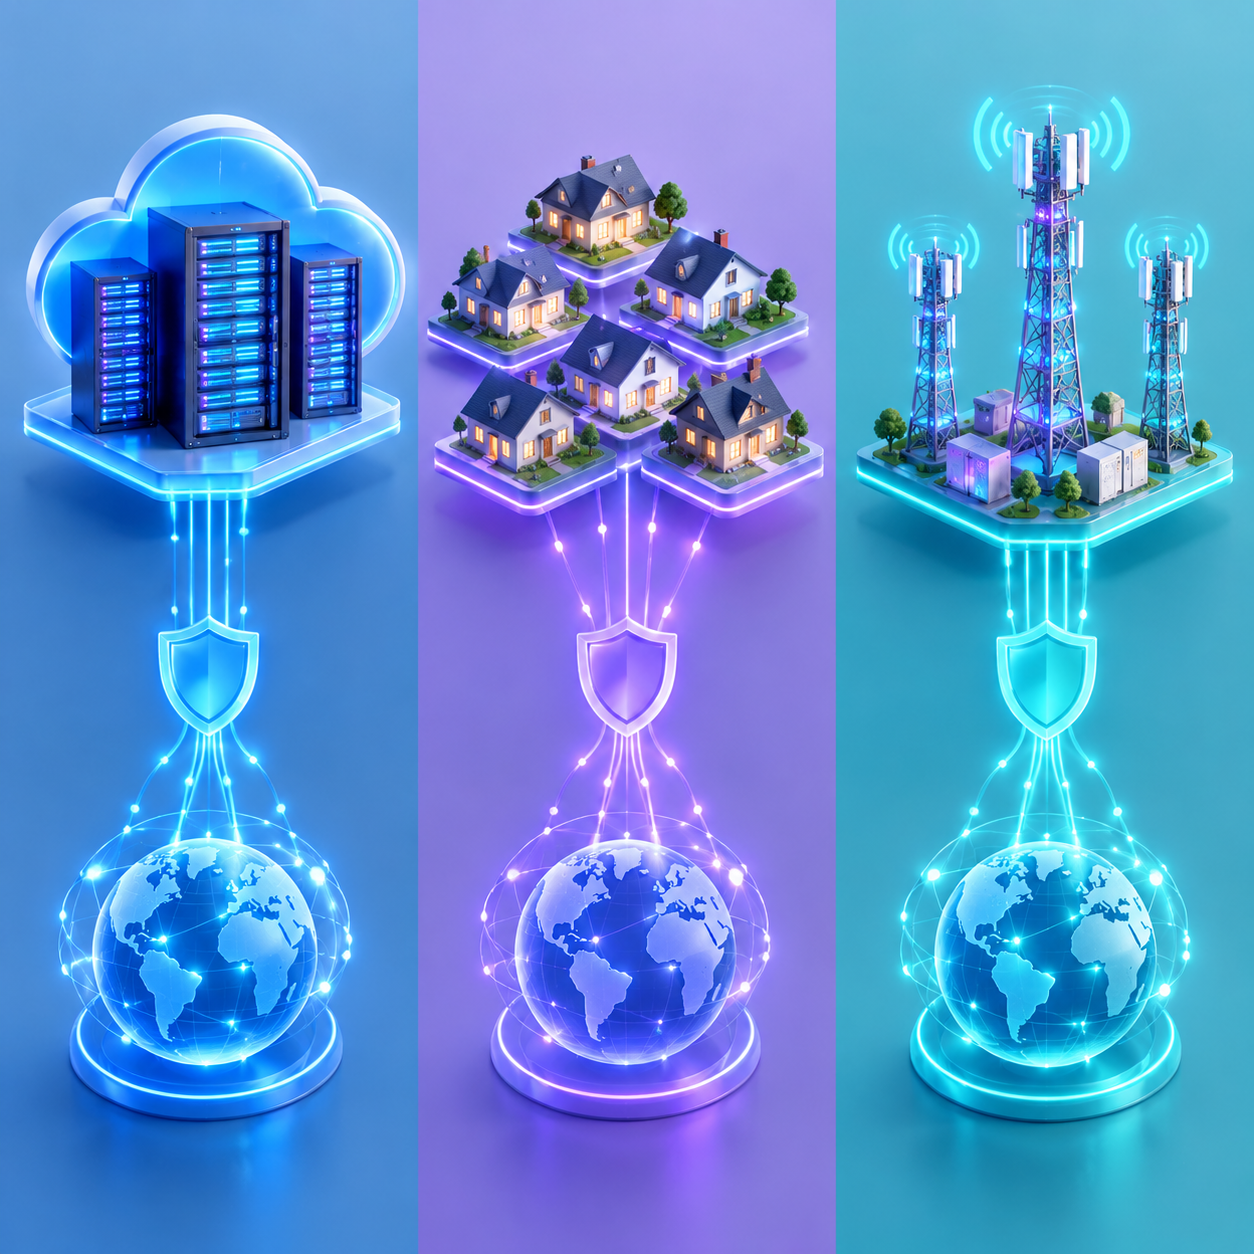 Разбор особенностей серверных, резидентских и мобильных прокси для обхода блокировок.
Не все прокси одинаково эффективны при парсинге цен в e-commerce:
- Datacenter Proxies (Серверные прокси): Обладают высокой скоростью и низкой стоимостью, однако диапазоны IP-адресов принадлежат облачным провайдерам (AWS, DigitalOcean и др.). Крупные маркетплейсы легко выявляют и блокируют такие подсети целиком.
- Residential Proxies (Резидентские прокси): Реальные IP-адреса, выдаваемые интернет-провайдерами (ISP) для домашних пользователей. Это наиболее эффективный тип прокси для скрапинга цен, так как трафик неотличим от действий реальных пользователей, а процент блокировок крайне мал.
- Mobile Proxies (Мобильные прокси 3G/4G/5G): Используют мобильное интернет-соединение, обладают наивысшим уровнем доверия, но стоят довольно дорого. Обычно используются как резервный вариант при работе с сайтами с самой строгой антибот-защитой.
3. Обработка динамических данных (JavaScript Rendering) и AJAX-запросов
Многие современные интернет-магазины скрывают информацию о ценах за AJAX-запросами API или формируют интерфейс с помощью React/Vue/Angular. Обычная отправка HTML-запросов не позволит получить цены товаров.
Оптимальный подход — использовать инструменты разработчика в браузере (F12, вкладка Network), чтобы найти прямой API-endpoint, возвращающий данные о ценах в формате JSON. Найдя этот endpoint, вам останется лишь отправлять запросы через Scrapy с использованием scrapy proxy middleware непосредственно к этому API. Это увеличивает скорость скрапинга в десятки раз по сравнению с использованием headless-браузеров, таких как Selenium или Playwright.
Обработка ошибок и мониторинг автоматизированной системы скрапинга
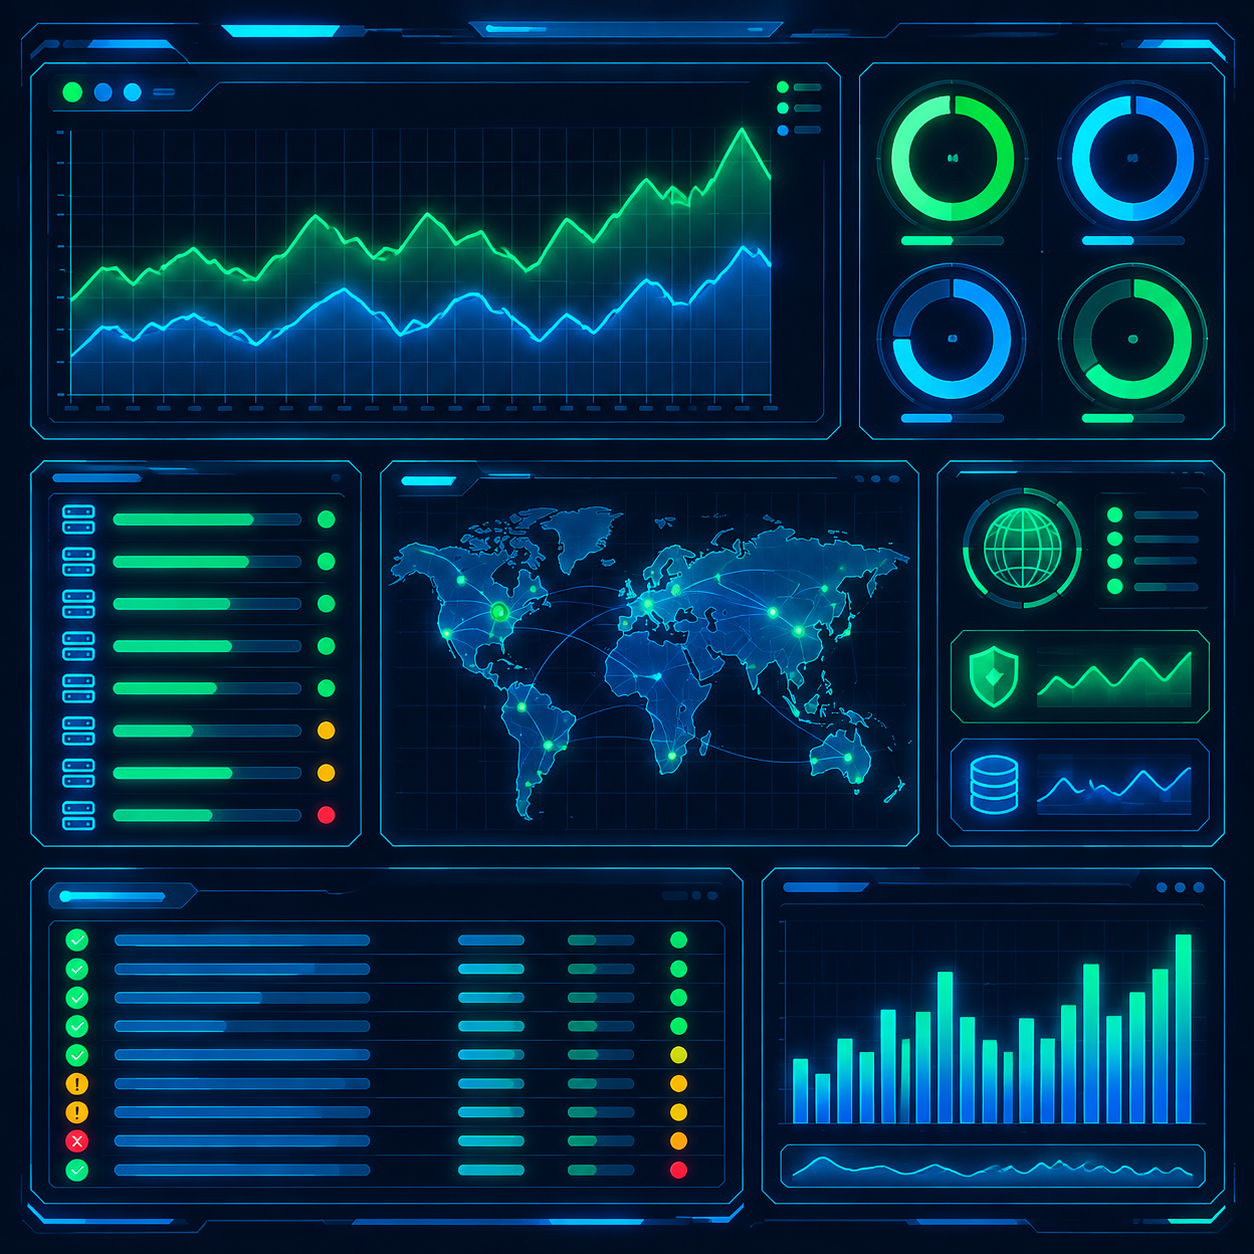 Дашборд мониторинга позволяет в реальном времени отслеживать процент успешных запросов и время отклика прокси.
Профессиональная система сбора цен конкурентов требует постоянного мониторинга. При развертывании rotating proxy scrapy необходимо отслеживать следующие ключевые показатели:
- Процент успешных ответов (Success Rate): Отношение ответов 200 OK к общему числу запросов. Этот показатель должен превышать 95%. Если он резко снижается, возможно, ваш список прокси попал в черный список или middleware настроен некорректно.
- Среднее время отклика (Latency): Промежуточные прокси могут увеличивать задержку. Установите разумное значение DOWNLOAD_TIMEOUT (обычно 10–15 секунд), чтобы вовремя отсеивать медленные прокси и не забивать очередь Scrapy.
- Обнаружение изменений в HTML-структуре: Иногда маркетплейсы не блокируют IP, а возвращают кастомную страницу с ошибкой или меняют структуру DOM. Напишите код для валидации выходных данных. Если поле цены постоянно принимает значение null, паук должен немедленно отправлять оповещение (alert).
Заключение
Автоматизация мониторинга цен конкурентов — это стратегический шаг, помогающий e-commerce компаниям сохранять конкурентоспособность и оптимизировать доходы. Сочетание асинхронного сбора данных в proxy scrapy python и решений rotating proxy scrapy полностью решает проблему антибот-защиты, обеспечивая стабильный и точный доступ к данным.
Освоив создание scrapy proxy middleware, выбрав правильные резидентские прокси и оптимизировав стратегию запросов, вы получите мощную инфраструктуру данных, готовую к бизнес-аналитике и автоматическому ценообразованию в цифровую эпоху.
Похожие статьи
Хватит читать — пора подключить настоящий прокси?
Residential, ISP, Datacenter или Mobile прокси — готовы за пару минут.
Смотреть продукты